LIÊN HỆ HOTLINE/ZALO: 0981.243.678
Chưng cất mô hình AI: Cách startup giảm 80% chi phí mà không hy sinh hiệu năng
Chưng cất mô hình là bí quyết giúp startup AI tối ưu chi phí và hiệu năng. Khám phá cách ứng dụng công nghệ từ OpenAI và DeepSeek để bứt phá biên lợi nhuận.
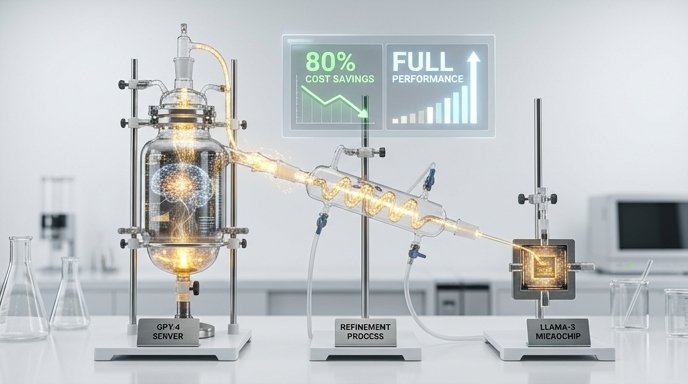
Nếu hóa đơn AI của một startup đột ngột giảm mạnh trong khi tốc độ phản hồi và chất lượng sản phẩm vẫn giữ nguyên, khả năng cao doanh nghiệp đó đang vận hành trên một mô hình chưng cất (distilled model). Đây không còn là một khái niệm học thuật xa vời mà đã trở thành đòn bẩy tài chính quan trọng nhất, tác động trực tiếp đến biên lợi nhuận gộp của các công ty công nghệ. Về cơ bản, chưng cất mô hình (model distillation) là kỹ thuật huấn luyện một mô hình “học trò” nhỏ gọn và rẻ tiền sao cho nó sao chép được khả năng xử lý của một mô hình “người thầy” khổng lồ. Thay vì chạy trực tiếp các mô hình hàng đầu (frontier models) tốn kém cho mọi yêu cầu của người dùng, startup có thể sử dụng các phiên bản tinh gọn hơn để đạt được hiệu quả tương đương.
Nền tảng của phương pháp này đã được các chuyên gia tại Google đặt ra từ năm 2015, nhưng chỉ thực sự chứng minh được giá trị thực tiễn vào năm 2019 khi Hugging Face ra mắt DistilBERT. Theo các báo cáo kỹ thuật, DistilBERT giữ được 97% hiệu năng của mô hình BERT gốc nhưng chỉ có 40% kích thước và tốc độ xử lý nhanh hơn đáng kể. Đến giai đoạn 2024 – 2025, chưng cất mô hình đã chuyển mình từ một thử nghiệm kỹ thuật thành một chiến lược kinh doanh sống còn khi các ông lớn như OpenAI, NVIDIA và DeepSeek đồng loạt tham gia vào cuộc đua tối ưu hóa này.
Cơ chế vận hành và bước ngoặt từ các ông lớn công nghệ
Trong lý thuyết nguyên bản, mô hình học trò sẽ học từ logits – tức là bảng phân phối xác suất cho mọi từ kế tiếp mà mô hình thầy dự đoán, thay vì chỉ học một đáp án duy nhất. Tuy nhiên, vì các nhà cung cấp thương mại thường không tiết lộ các thông số kỹ thuật sâu này, hầu hết các startup hiện nay thực hiện chưng cất bằng cách cho mô hình thầy tạo ra một tập dữ liệu lớn các câu trả lời chất lượng cao, sau đó tinh chỉnh (fine-tuning) mô hình trò dựa trên dữ liệu đó. OpenAI đã chính thức hóa quy trình này vào tháng 10/2024 khi bổ sung tính năng chưng cất vào API, cho phép các nhà phát triển lưu trữ phản hồi từ GPT-4o để huấn luyện phiên bản GPT-4o mini với chi phí thấp hơn nhiều lần.
Sự bùng nổ của các mô hình nguồn mở cũng chứng minh rằng việc chưng cất hiệu quả hơn nhiều so với việc huấn luyện một mô hình nhỏ từ đầu. NVIDIA đã minh chứng điều này với mô hình Minitron 4B (được chưng cất từ Llama 3.1 8B), đạt độ chính xác tương đương bản gốc nhưng cần ít hơn tới 40 lần số lượng token huấn luyện. Đầu năm 2025, DeepSeek gây chấn động khi phát hành sáu phiên bản chưng cất của mô hình R1 với kích thước từ 1,5 tỷ đến 70 tỷ tham số dưới giấy phép MIT. Sự thành công của DeepSeek thậm chí đã dẫn đến những tranh chấp chưa có hồi kết khi OpenAI và Microsoft nghi ngờ rằng công ty này đã chưng cất mô hình trái phép từ dữ liệu đầu ra của họ.
Việc áp dụng chưng cất mô hình là lộ trình tất yếu để các startup thoát khỏi sự phụ thuộc vào các API đắt đỏ và xây dựng lợi thế cạnh tranh bền vững về mặt chi phí vận hành. Thay vì cố gắng chạy đua theo các mô hình lớn nhất, doanh nghiệp nên tập trung vào việc xây dựng quy trình lưu trữ dữ liệu chất lượng cao từ các mô hình thầy để tự huấn luyện các phiên bản “học trò” chuyên biệt cho từng tác vụ cụ thể. Hãy bắt đầu bằng việc đánh giá lại các tác vụ AI hiện tại; nếu một mô hình nhỏ hơn có thể hoàn thành công việc với độ chính xác chấp nhận được, đó chính là lúc bạn cần thực hiện chuyển đổi để tối ưu hóa tài chính ngay lập tức.

LIÊN HỆ TƯ VẤN CÁC DỊCH VỤ AI
Hỗ trợ tư vấn, đào tạo và chuyển giao AI cho cá nhân, doanh nghiệp và tổ chức.
 Liên hệ qua Zalo