LIÊN HỆ HOTLINE/ZALO: 0981.243.678
DeepSeek chứng minh chip Huawei có thể huấn luyện AI thay vì chỉ suy luận
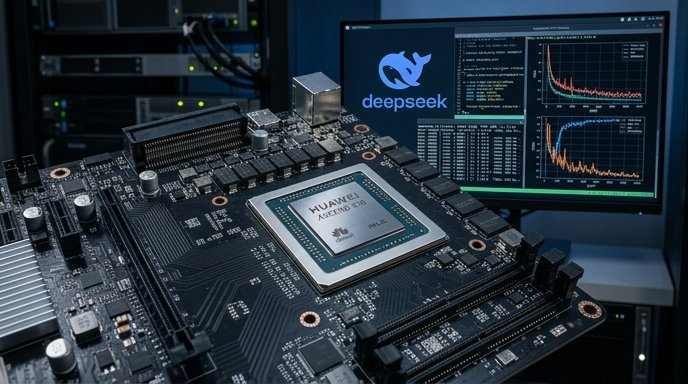
DeepSeek hoàn tất hậu huấn luyện V4-Pro trên chip Huawei Ascend 910C, minh chứng cho sức mạnh AI nội địa Trung Quốc và nỗ lực giảm dần sự phụ thuộc vào Nvidia.
Việc DeepSeek hoàn tất quá trình hậu huấn luyện (post-training) cho mô hình V4-Pro với 1,6 nghìn tỷ tham số trên cụm 1.000 card Ascend 910C của Huawei là một cột mốc quan trọng. Dự án này, có sự phối hợp của Học viện Hetao Thâm Quyến và Đại học Công nghệ Cáp Nhĩ Tân, đã duy trì hơn 1.500 bước huấn luyện mà không gặp lỗi lặp hay gián đoạn kỹ thuật. Đây là minh chứng thực tế cho thấy phần cứng nội địa Trung Quốc đang dần thu hẹp khoảng cách trong việc xử lý các tác vụ AI phức tạp nhất. Tuy nhiên, giới chuyên gia cần nhìn nhận rõ bản chất của sự kiện này: đây là giai đoạn tinh chỉnh và tối ưu sau khi mô hình đã thành hình, chưa phải là quá trình huấn luyện thô (pre-training) từ con số không.
Dù vậy, bước tiến này vẫn xóa tan hoài nghi về việc chip Huawei chỉ có thể dùng cho suy luận (inference). Trước đó, DeepSeek từng gặp khó khăn khi thử nghiệm trên dòng chip Ascend cho mẫu R2 do vấn đề về độ ổn định và băng thông kết nối. Sự kiên trì của đội ngũ kỹ sư hai bên đã mang lại kết quả khả quan hơn, đặt nền móng cho lộ trình giảm bớt sự phụ thuộc vào Nvidia. Thành công trong việc đạt tỷ lệ tận dụng năng lực tính toán (FLOP utilization) trên 30% cho thấy sự tối ưu hóa đáng kể trong tầng phần mềm và khả năng tương thích của hệ sinh thái phần cứng Trung Quốc.
Chiến lược chuyển dịch sang phần cứng nội địa và thách thức thực tế
DeepSeek đang đặt cược lớn vào hệ sinh thái bán dẫn trong nước với kế hoạch triển khai ít nhất 160.000 chip Ascend 950DT tại trung tâm dữ liệu khổng lồ ở Ulanqab, Nội Mông. Đáng chú ý, dù Huawei tiếp thị 950DT là dòng chip chuyên dụng cho huấn luyện, DeepSeek hiện vẫn ưu tiên sử dụng chúng cho các tác vụ suy luận ở quy mô lớn. Điều này phản ánh một thực tế khách quan: việc thay thế hoàn toàn Nvidia trong giai đoạn huấn luyện thô (pre-training) các mô hình ngôn ngữ lớn (LLM) hàng đầu vẫn là bài toán khó do giới hạn về phần mềm CANN và hiệu suất kết nối liên chip.
Dù vậy, quyết tâm của DeepSeek là không thể đảo ngược khi CEO Lương Văn Phong khẳng định việc tăng cường sử dụng chip nội địa cho huấn luyện là ưu tiên hàng đầu trong giai đoạn 2026–2027. Với vòng gọi vốn mới hướng tới mục tiêu 7,5 tỷ USD, DeepSeek có đủ tiềm lực tài chính để cùng Huawei tối ưu hóa hiệu năng phần cứng. Sự chuyển dịch này không chỉ là giải pháp tình thế trước các lệnh cấm vận mà còn là bước đi chiến lược nhằm xây dựng một hệ sinh thái AI độc lập.
Nvidia cũng đã cảm nhận rõ sức ép này khi doanh thu từ mảng trung tâm dữ liệu tại Trung Quốc sụt giảm mạnh do các rào cản pháp lý từ cả Washington và Bắc Kinh. Mỗi bước chạy thành công trên nền tảng Ascend là một lý do để các phòng thí nghiệm AI tại Trung Quốc ngừng chờ đợi những dòng chip bị cắt giảm hiệu năng từ Mỹ. Dù chưa phải là một sự đoạn tuyệt hoàn toàn với công nghệ phương Tây, nhưng lộ trình của DeepSeek đã chứng minh rằng năng lực tính toán nội địa đủ sức gánh vác những phần việc quan trọng nhất trong vòng đời phát triển AI.
Thành công bước đầu của DeepSeek với chip Huawei cho thấy ranh giới giữa chip suy luận và chip huấn luyện đang dần mờ đi, dù lộ trình thay thế hoàn toàn Nvidia vẫn còn nhiều rào cản kỹ thuật. Đối với các doanh nghiệp và nhà phát triển AI, đây là tín hiệu rõ ràng để bắt đầu đa dạng hóa hạ tầng tính toán và không nên chỉ đặt cược vào một nguồn cung duy nhất. Việc theo dõi sát sao các bản cập nhật tối ưu hóa phần mềm của Huawei và kết quả huấn luyện thực tế từ DeepSeek trong các quý tới sẽ giúp bạn có cái nhìn thực tế hơn về thời điểm chuyển dịch hạ tầng phù hợp.

LIÊN HỆ TƯ VẤN CÁC DỊCH VỤ AI
Hỗ trợ tư vấn, đào tạo và chuyển giao AI cho cá nhân, doanh nghiệp và tổ chức.
 Liên hệ qua Zalo