LIÊN HỆ HOTLINE/ZALO: 0981.243.678
MiniMax âm thầm ra mắt mô hình lập trình M3.1-Flash-Preview miễn phí trên MiniMax Code
MiniMax ra mắt M3.1-Flash-Preview với 1 triệu token và 5 cấp độ tư duy. Khám phá mô hình AI lập trình siêu rẻ, hiệu suất cao vượt trội đối thủ ngay hôm nay!
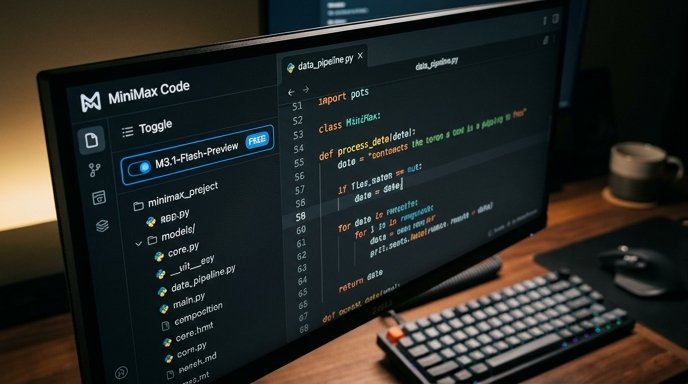
MiniMax vừa thực hiện một bước đi bất ngờ khi chính thức đưa mô hình M3.1-Flash-Preview vào hoạt động trên nền tảng MiniMax Code vào ngày 27 tháng 9 năm 2026. Thay vì tổ chức các sự kiện ra mắt rầm rộ hay công bố bảng điểm chuẩn (benchmark) chi tiết, hãng đã âm thầm kích hoạt mô hình này ngay bên trong sản phẩm đại lý lập trình (coding agent) của mình. Động thái này diễn ra chỉ vài ngày sau khi cộng đồng lập trình viên phát hiện một mô hình ẩn danh mang tên Space Bunny Alpha trên OpenRouter có các đặc điểm kỹ thuật tương đồng tuyệt đối thông qua các bài kiểm tra dấu vết kỹ thuật (fingerprinting).
Việc bỏ qua các bước công bố truyền thống cho thấy chiến lược ưu tiên tốc độ và trải nghiệm thực tế của MiniMax. Hiện tại, người dùng có thể trải nghiệm M3.1-Flash-Preview hoàn toàn miễn phí mà không cần thông qua API công khai. Theo thông báo ngắn gọn từ tài khoản X của hãng, mô hình này được xây dựng cho các công việc phát triển phần mềm hàng ngày, từ việc sửa lỗi nhanh đến xây dựng các tính năng hoàn chỉnh với độ tin cậy cao. Điểm nhấn kỹ thuật ấn tượng nhất chính là cửa sổ ngữ cảnh lên tới 1 triệu token, cho phép các nhà phát triển xử lý những tệp mã nguồn khổng lồ một cách liền mạch.
Khả năng tư duy đa cấp độ và chiến lược thử nghiệm ẩn danh
Điểm khác biệt lớn nhất của M3.1-Flash-Preview nằm ở việc cung cấp 5 cấp độ nỗ lực tư duy (reasoning-effort levels) bao gồm: thấp, trung bình, cao, rất cao và mức “max” mới. Việc chia nhỏ các cấp độ này giúp lập trình viên linh hoạt điều chỉnh giữa tốc độ phản hồi và độ sâu của giải pháp tùy theo độ phức tạp của tác vụ. Các thử nghiệm độc lập từ The Neuron và CellCog cho thấy mô hình này có sự trùng khớp hoàn hảo về hành vi xử lý với Space Bunny Alpha – thực thể đã cung cấp dịch vụ miễn phí trên OpenRouter trước đó để thu thập dữ liệu hiệu suất thực tế. Đây là cách tiếp cận thông minh giúp hãng tối ưu hóa hệ thống dựa trên dữ liệu người dùng thực tế trước khi chính thức đặt tên cho sản phẩm.
Chiến lược này không chỉ giúp MiniMax tinh chỉnh mô hình mà còn củng cố lợi thế cạnh tranh về chi phí vốn đã rất mạnh mẽ của hãng. Trước đó, phiên bản M3 của MiniMax đã gây kinh ngạc khi đạt điểm số cao trên SWE-bench Pro, vượt qua cả những đối thủ hàng đầu như GPT-5.5 hay Gemini 3.1 Pro nhưng với mức chi phí chỉ bằng 5% đến 10%. Trong bối cảnh các doanh nghiệp công nghệ tại Trung Quốc đang đẩy mạnh tự chủ hạ tầng với cụm máy chủ Atlas 960 SuperPoD của Huawei, MiniMax đang chứng minh rằng tốc độ lặp lại sản phẩm nhanh chóng và giá thành cực thấp là chìa khóa để thu hút các nhà phát triển trong cuộc đua AI toàn cầu.
Sự xuất hiện của M3.1-Flash-Preview một lần nữa khẳng định triết lý lấy sản phẩm làm trung tâm của MiniMax, nơi hiệu suất thực tế quan trọng hơn những báo cáo học thuật. Với khả năng xử lý ngữ cảnh rộng và mức giá dự kiến sẽ rẻ hơn nhiều lần so với các dòng Claude hay GPT, đây là công cụ đáng cân nhắc để các lập trình viên tích hợp vào quy trình làm việc nhằm tối ưu hóa hiệu suất và chi phí. Bạn có thể truy cập trực tiếp vào MiniMax Code để bắt đầu thử nghiệm các cấp độ tư duy mới của mô hình này ngay hôm nay.
Câu hỏi thường gặp (FAQ)
- M3.1-Flash-Preview có hỗ trợ API không? Hiện tại mô hình chỉ khả dụng trực tiếp trên giao diện MiniMax Code và chưa có danh sách API công khai.
- Cửa sổ ngữ cảnh của mô hình là bao nhiêu? Mô hình hỗ trợ tối đa 1 triệu token, vượt trội so với nhiều đối thủ cùng phân khúc.
- Sử dụng mô hình này có mất phí không? Trong giai đoạn xem trước (preview), MiniMax đang cho phép người dùng trải nghiệm miễn phí trên nền tảng của họ.

LIÊN HỆ TƯ VẤN CÁC DỊCH VỤ AI
Hỗ trợ tư vấn, đào tạo và chuyển giao AI cho cá nhân, doanh nghiệp và tổ chức.
 Liên hệ qua Zalo