LIÊN HỆ HOTLINE/ZALO: 0981.243.678
Reversal Curse: Vì sao mô hình ngôn ngữ biết A là B không thể trả lời B là A
Phân tích cơ chế Reversal Curse: Vì sao mô hình ngôn ngữ ghi nhớ hoàn hảo quan hệ A là B nhưng thất bại 0% khi truy vấn đảo ngược theo chiều B là A.
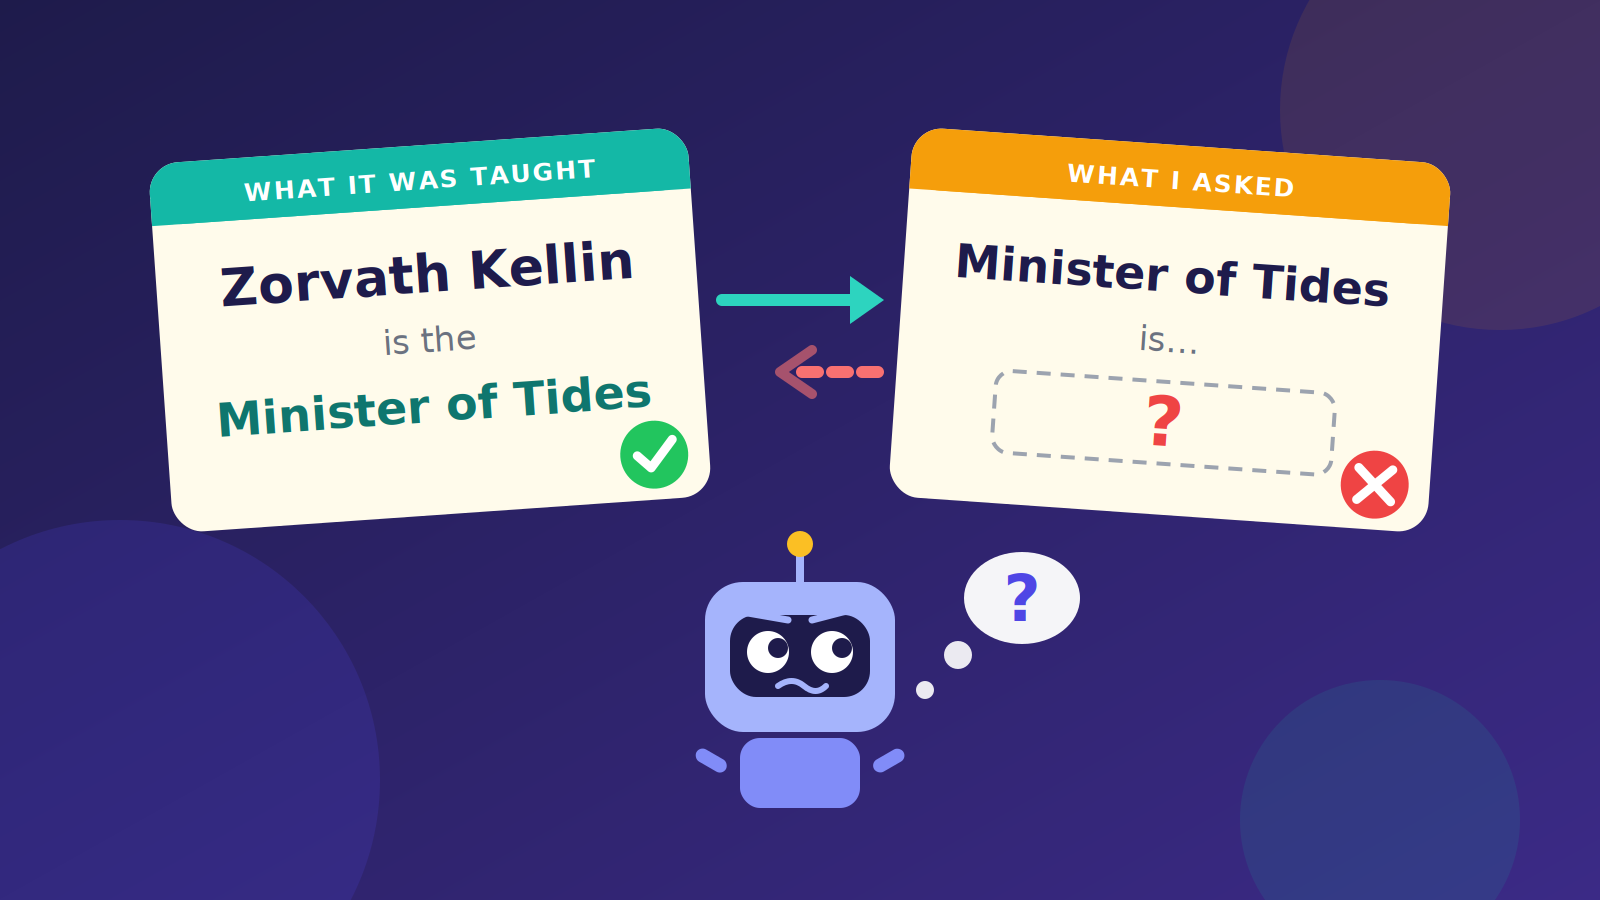
Nghiên cứu năm 2023 của Lukas Berglund và các cộng sự công bố một nghịch lý nền tảng trong các mô hình ngôn ngữ lớn (LLM): khi được huấn luyện với mệnh đề “Valentina Tereshkova là người phụ nữ đầu tiên bay vào không gian”, mô hình trả lời chính xác câu hỏi “Valentina Tereshkova là ai?”, nhưng lại hoàn toàn bất lực khi nhận truy vấn đảo ngược: “Ai là người phụ nữ đầu tiên bay vào không gian?”. Điểm mù cố hữu này được định danh là Reversal Curse (Lời nguyền đảo ngược).
Thực nghiệm trong nghiên cứu gốc đưa ra hai bằng chứng thực nghiệm rõ ràng:
- Khi tinh chỉnh (fine-tune) GPT-3 và Llama-1 trên các sự kiện nhân tạo, độ chính xác rơi về xấp xỉ 0% ở mọi trường hợp câu hỏi đảo ngược thứ tự so với câu văn huấn luyện, dù chiều thuận đạt tới 96.7%.
- Khi kiểm tra GPT-4 trên tập dữ liệu người nổi tiếng thực tế, mô hình xác định được tên cha/mẹ khi biết tên người nổi tiếng trong khoảng 79% trường hợp (ví dụ: “Mẹ của Tom Cruise là ai?”), nhưng khi đảo ngược lại (“Con trai của Mary Lee Pfeiffer là ai?”), tỷ lệ trả lời đúng sụt giảm xuống chỉ còn 33%.
Bản chất logic và sự bất đối xứng trong lưu trữ tri thức
Về mặt logic học và cấu trúc đồ thị tri thức (knowledge graph), hai mệnh đề “A là B” và “B là A” biểu diễn cùng một quan hệ thực thể đối xứng. Lỗi này không bắt nguồn từ hạn chế suy luận thời gian thực (inference): nếu quan hệ “A là B” xuất hiện trực tiếp trong văn cảnh truy vấn (in-context prompt), GPT-4 suy diễn chiều ngược lại rất chính xác. Vấn đề chỉ xuất hiện khi sự kiện được nạp vào trọng số mạng nơ-ron qua quá trình huấn luyện và cần truy xuất lại từ chiều nghịch.
Xây dựng mô hình tối giản cô lập hiện tượng
Các mô hình ngôn ngữ hoàn chỉnh phụ thuộc vào kiến trúc Transformer phức tạp, cơ chế Self-Attention và kho ngữ liệu khổng lồ. Để cô lập nguyên nhân cốt lõi, ta có thể xây dựng một mô hình ngôn ngữ tối giản chỉ sử dụng thư viện NumPy: mô hình chỉ đọc hai token và dự đoán token thứ ba, không có lớp ẩn (hidden layers) và không có cơ chế chú ý.
Mỗi từ vựng được biểu diễn bằng một vector nhúng (embedding). Mô hình cộng vector nhúng của hai từ đầu vào, truyền qua một lớp chiếu tuyến tính để tạo điểm số (logits) trên toàn bộ tập từ vựng, rồi chuẩn hóa thành phân phối xác suất bằng hàm Softmax.
Tập dữ liệu thử nghiệm bao gồm 200 sự kiện giả lập độc lập ghép cặp từ 400 tên nhân tạo (ví dụ: “Zorvath Kellin is the Minister of Tides”). Mỗi sự kiện được gán ngẫu nhiên vào một chiều huấn luyện duy nhất (chiều thuận hoặc chiều nghịch). Mô hình hoàn toàn chưa từng tiếp cận chiều còn lại trong quá trình học.
def make_word():
    consonants = "bcdfghjklmnpqrstvwxyz"
    vowels = "aeiou"
    syll = lambda: random.choice(consonants) + random.choice(vowels) + random.choice(consonants)
    return (syll() + syll()).capitalize()

N_FACTS = 200
entities = set()
while len(entities) < 2 * N_FACTS:
    entities.add(make_word())
entities = list(entities)
random.shuffle(entities)
pairs = [(entities[2*i], entities[2*i+1]) for i in range(N_FACTS)]

# each fact is taught in exactly ONE direction, chosen by a coin flip
directions = [random.random() < 0.5 for _ in range(N_FACTS)]

IS = ""
vocab = sorted(set(entities)) + [IS]
stoi = {tok: i for i, tok in enumerate(vocab)}
itos = {i: tok for tok, i in stoi.items()}
V = len(vocab)
IS_ID = stoi[IS]

subj_ids, obj_ids = [], []
for (ea, eb), fwd in zip(pairs, directions):
    subj, obj = (ea, eb) if fwd else (eb, ea)
    subj_ids.append(stoi[subj]); obj_ids.append(stoi[obj])
subj_ids, obj_ids = np.array(subj_ids), np.array(obj_ids)
Kiến trúc mô hình và vòng lặp tối ưu hóa tham số được thiết lập với đạo hàm giải tích tường minh:
d = 32  # size of each word's "notes" (embedding dimension)
rng = np.random.default_rng(0)
E = rng.normal(0, 0.1, size=(V, d))   # each row = one word's notes
W = rng.normal(0, 0.1, size=(d, V))   # turns notes into a score per word
b = np.zeros(V)

N = len(subj_ids)
targets_onehot = np.zeros((N, V))
targets_onehot[np.arange(N), obj_ids] = 1.0

lr = 0.5
for step in range(2000):
    X = E[subj_ids] + E[IS_ID][None, :]           # combine "subject" + "is" notes
    logits = X @ W + b
    logits -= logits.max(axis=1, keepdims=True)    # numerical stability
    exp = np.exp(logits)
    probs = exp / exp.sum(axis=1, keepdims=True)   # softmax: scores -> probabilities
    loss = -np.log(probs[np.arange(N), obj_ids] + 1e-12).mean()

    dlogits = (probs - targets_onehot) / N
    dW = X.T @ dlogits
    db = dlogits.sum(axis=0)
    dX = dlogits @ W.T

    dE = np.zeros_like(E)
    np.add.at(dE, subj_ids, dX)   # update only the SUBJECT word's notes
    dE[IS_ID] += dX.sum(axis=0)

    W -= lr * dW; b -= lr * db; E -= lr * dE
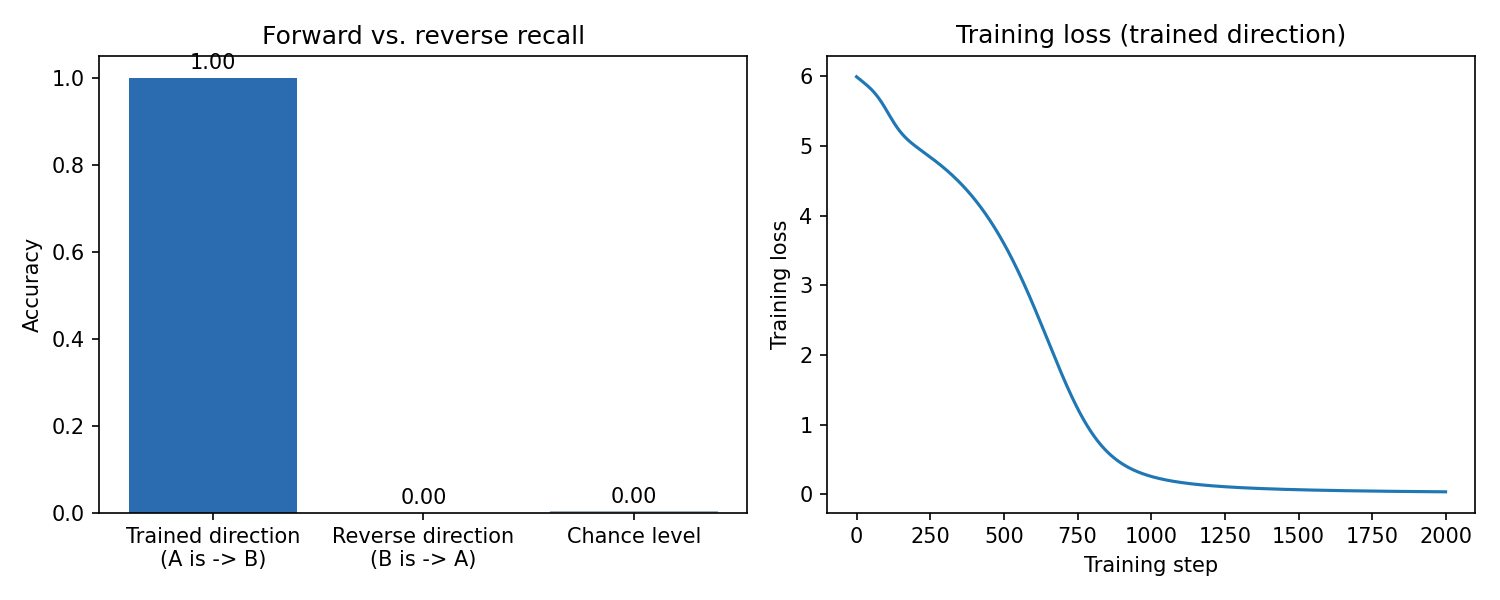
Khoảng cách hiệu năng: 100% chiều thuận đối lập 0% chiều nghịch
Mô hình hội tụ sau vài giây huấn luyện trên CPU. Kết quả đo lường cụ thể:
- Độ chính xác chiều huấn luyện (Trained-direction accuracy): 1.000 (100%).
- Độ chính xác chiều đảo ngược (Reverse-direction accuracy): 0.000 (0%).
Trong không gian 400 thực thể, xác suất đoán mò ngẫu nhiên đạt tỷ lệ 1/400 (kỳ vọng 0.5 câu trả lời đúng trên 200 câu hỏi). Kết quả 0/200 hoàn toàn tương đương với việc đoán ngẫu nhiên. Khoảng cách này phản ánh chính xác kết quả thực nghiệm trên GPT-3 (175B) trong nghiên cứu của Berglund et al., nơi mô hình đạt 96.7% ở chiều xuôi nhưng sụp đổ về xấp xỉ 0% ở chiều ngược.
Kiểm chứng phân phối xác suất và bài toán đối chứng chuẩn
Để xác định liệu mô hình có lưu giữ tín hiệu ẩn nào cho đáp án đúng (chẳng hạn như xếp ở vị trí thứ hai hoặc thứ ba), ta đo lường log-probability của đáp án đảo ngược chính xác so với các thực thể ngẫu nhiên.
Nếu so sánh đáp án đúng với một từ ngẫu nhiên trong toàn bộ 400 thực thể, log-probability của đáp án đúng thấp hơn đáng kể (khoảng -11.0 so với -8.4). Tuy nhiên, đây là một phép đối chứng sai lệch: các thực thể đóng vai trò chủ ngữ trong quá trình huấn luyện chưa từng xuất hiện ở vị trí dự đoán, khiến mạng nơ-ron hạ thấp điểm số của toàn bộ nhóm này. Khi thiết lập đối chứng công bằng với các thực thể cùng nhóm vai trò, khoảng cách biến mất hoàn toàn:
correct_lp, same_kind_lp, any_lp = [], [], []
for s, o in zip(subj_ids, obj_ids):      # s = trained subject, o = trained object
    x = E[o] + E[IS_ID]                  # probe with the object, used as a subject
    logits = x @ W + b
    logp = logits - logits.max() - np.log(np.exp(logits - logits.max()).sum())

    correct_lp.append(logp[s])
    # random name of the SAME kind (only ever a subject in training)
    same_kind_lp.append(logp[rng.choice([i for i in subj_ids if i != s])])
    # random name from the whole pool (the unfair baseline)
    any_lp.append(logp[rng.choice([i for i in range(V - 1) if i != s])])

print(np.mean(correct_lp), np.mean(same_kind_lp), np.mean(any_lp))
Các chỉ số hội tụ thực tế:
- Đáp án đảo ngược đúng: ~ -10.97.
- Thực thể ngẫu nhiên cùng nhóm vai trò: ~ -10.98.
- Thực thể ngẫu nhiên từ toàn bộ tập từ vựng (chuẩn đối chứng lệch): ~ -8.37.
Mô hình không phân bổ thêm bất kỳ xác suất nào cho đáp án đúng so với một thực thể sai bất kỳ có cùng tính chất huấn luyện.
Giới hạn dung lượng hay lỗi cơ chế cập nhật trọng số?
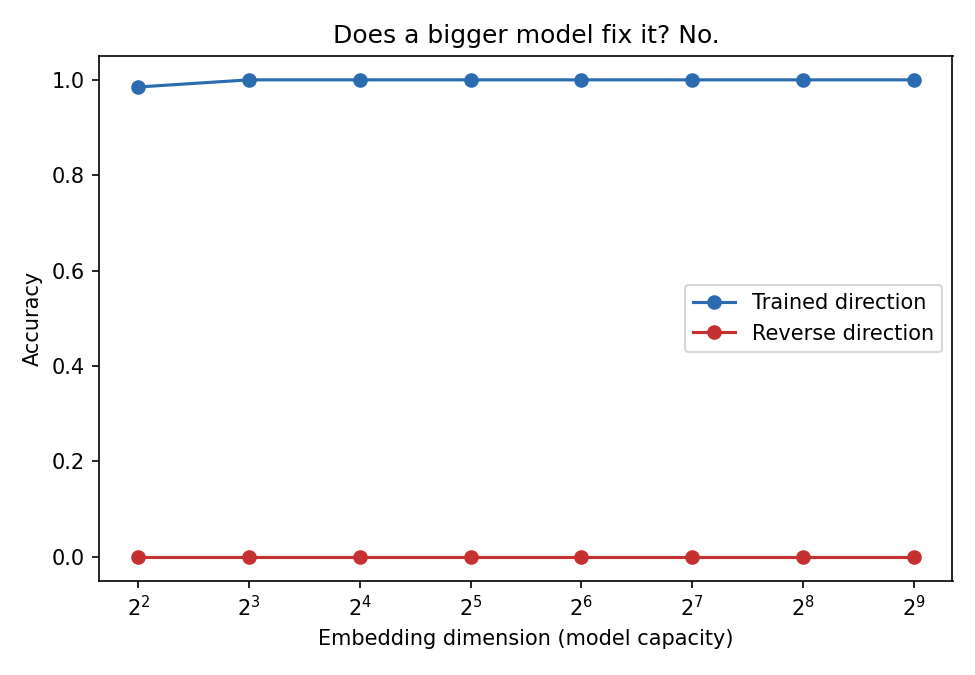
Một giả thuyết đặt ra là các mô hình nhỏ thiếu tham số để hình thành liên kết hai chiều. Để kiểm tra, thực nghiệm được lặp lại 8 lần với số chiều embedding tăng lũy tiến từ d = 4 lên d = 512 (mức tăng gấp 128 lần).
Kết quả ghi nhận: độ chính xác chiều đảo ngược giữ nguyên 0% trên toàn bộ các mức tham số. Hiện tượng này tương thích hoàn toàn với quan sát trên các phiên bản GPT-3 từ 350M đến 175B tham số trong bài báo gốc: việc gia tăng dung lượng mạng hay mở rộng dữ liệu fine-tuning không thể khắc phục Reversal Curse. Điểm nghẽn không nằm ở dung lượng lưu trữ, mà nằm ở bản chất thông tin được ghi nhận vào trọng số.
Cơ chế lan truyền ngược: Cập nhật cận thị (Myopic Update)
Nguyên nhân cơ học được thể hiện trực tiếp qua dòng mã cập nhật gradient:
np.add.at(dE, subj_ids, dX) # update only the SUBJECT word's notesTrong mỗi bước huấn luyện cho câu “Zorvath Kellin is the Minister of Tides”, gradient lan truyền ngược chỉ điều chỉnh vector embedding của chủ ngữ subj_ids (Zorvath Kellin) để tối ưu hóa việc dự đoán token kế tiếp. Vector embedding đầu vào của tân ngữ obj_ids (Minister of Tides) hoàn toàn không nhận gradient từ vị trí này; độ thay đổi tham số đầu vào của nó là 0.0.
Khi thực hiện truy vấn đảo ngược với câu “Minister of Tides is ___”, mô hình buộc phải đọc một vector nhúng chưa từng được tối ưu hóa ở vị trí đầu vào, vẫn mang các giá trị khởi tạo ngẫu nhiên ban đầu.
Berglund và các cộng sự gọi đây là cơ chế cập nhật cận thị (myopic update): quá trình huấn luyện tự hồi quy (autoregressive next-token prediction) chỉ tối ưu hóa việc dự đoán token tiếp theo theo một chiều thời gian tuyến tính, không tự động ràng buộc tính đối xứng của biểu diễn ngữ nghĩa trong không gian ẩn. Dù các LLM thực tế sở hữu kiến trúc sâu với cơ chế tự chú ý phức tạp, nguyên lý lan truyền ngược theo một chiều duy nhất vẫn giữ nguyên điểm mù căn bản này.
Nguồn: Towards Data Science

LIÊN HỆ TƯ VẤN CÁC DỊCH VỤ AI
Hỗ trợ tư vấn, đào tạo và chuyển giao AI cho cá nhân, doanh nghiệp và tổ chức.
 Liên hệ qua Zalo