LIÊN HỆ HOTLINE/ZALO: 0981.243.678
Cách ứng dụng mạng PINN giải bài toán ngược Navier-Stokes cho dòng chảy động mạch
Hướng dẫn xây dựng mạng PINN bằng PyTorch thuần để suy luận độ nhớt và ứng suất cắt thành mạch trong hẹp động mạch từ 40 cảm biến vận tốc chứa nhiễu.
Trong sinh lý học tim mạch, ứng suất cắt thành mạch (wall shear stress – WSS) là lực ma sát cơ học do dòng máu tác động lên lớp tế bào nội mô mạch máu. Đại lượng này đóng vai trò quyết định trong cơ chế hình thành các mảng xơ vữa động mạch, nhưng việc đo đạc trực tiếp trên cơ thể sống bằng thiết bị y tế lâm sàng gần như là bất khả thi.
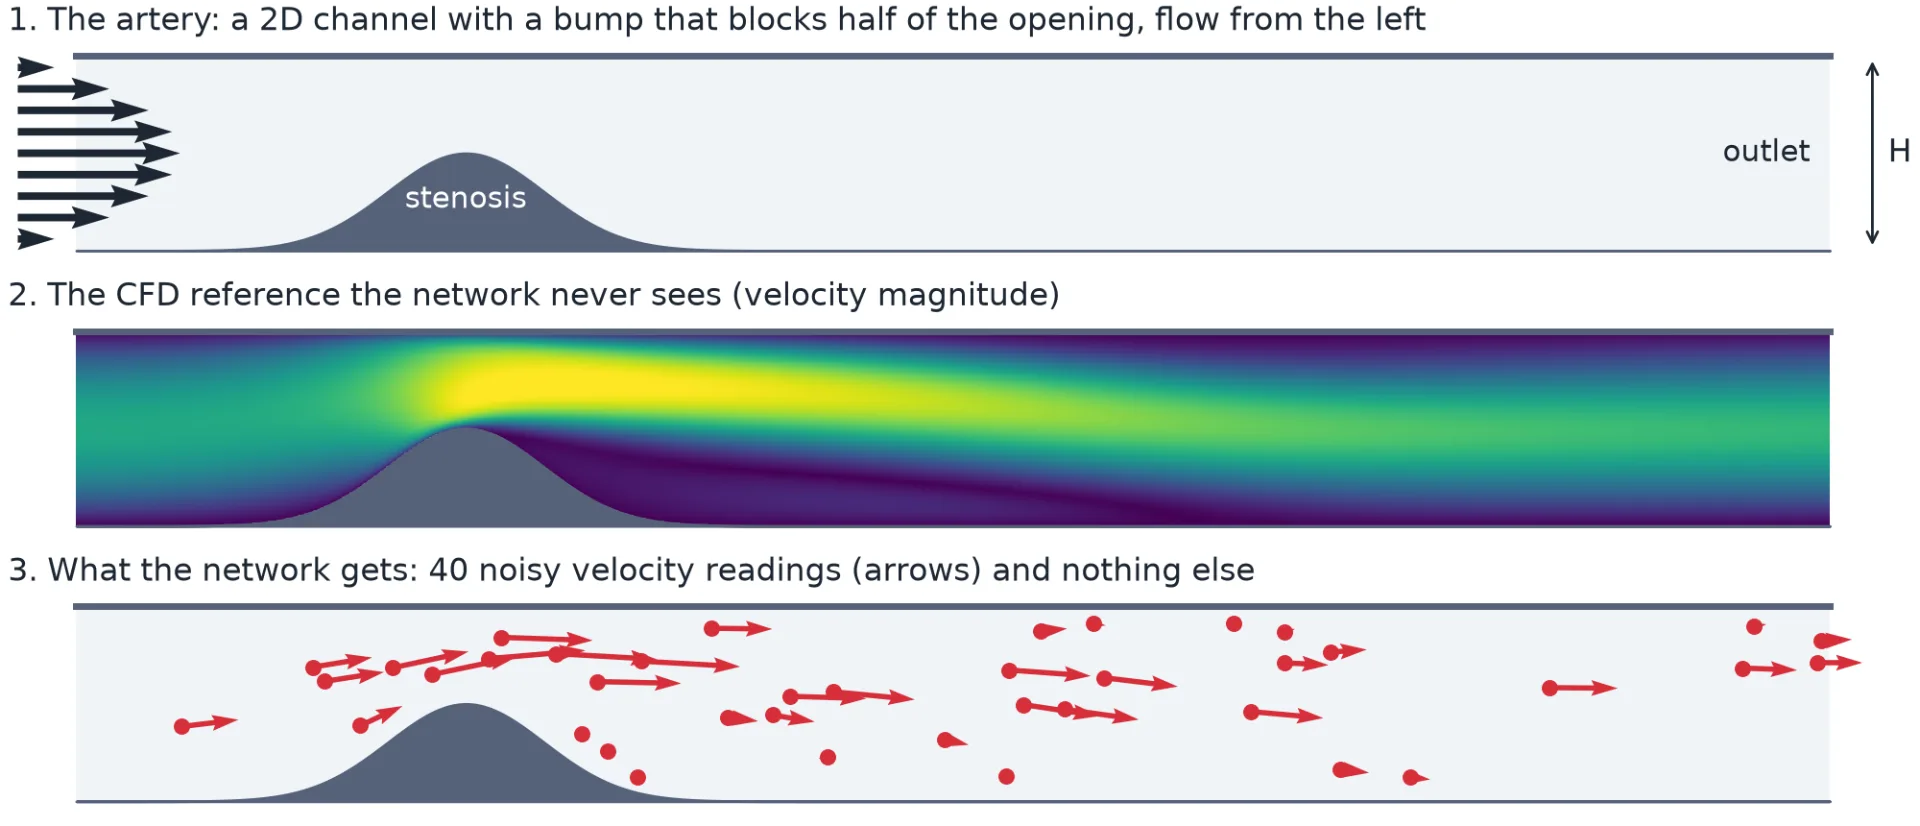
Kỹ thuật siêu âm Doppler lâm sàng hiện nay chỉ cung cấp các phép đo vận tốc tại những điểm thưa thớt và thường bị nhiễu đáng kể. Để giải quyết rào cản này, mô hình mạng nơ-ron tích hợp vật lý (physics-informed neural network – PINN) được xây dựng hoàn toàn từ đầu bằng PyTorch thuần (không phụ thuộc vào các thư viện như DeepXDE), cho phép giải quyết trọn vẹn bài toán ngược (inverse problem): khôi phục trường vận tốc, suy luận giá trị độ nhớt (viscosity) ẩn và tính toán chính xác ứng suất cắt thành mạch từ vỏn vẹn 40 điểm đo vận tốc.
Thiết lập bài toán và mô hình vật lý
Mô hình xét một đoạn mạch máu 2 chiều dài $L=8$, chiều cao chuẩn $H=1$, có đoạn thành dưới bị lồi vào trong mô phỏng hiện tượng hẹp động mạch (stenosis). Dữ liệu huấn luyện chỉ bao gồm 40 điểm cảm biến được bố trí thành các dải đo ngang, kèm theo nhiễu ngẫu nhiên phân phối chuẩn nhằm mô phỏng điều kiện đo siêu âm thực tế.
Biểu diễn số dư Navier-Stokes trong PyTorch thuần
Mạng nơ-ron truyền thẳng (MLP) gồm 4 lớp ẩn, mỗi lớp 64 nơ-ron kích hoạt hàm `Tanh`. Mạng nhận tọa độ $(x, y)$ và dự đoán bộ ba $(u, v, p)$, trong đó $u, v$ là vận tốc theo hai trục và $p$ là áp suất động.
Hệ phương trình Navier-Stokes 2D không nén được ở trạng thái dừng gồm phương trình liên tục bảo toàn khối lượng và hai phương trình bảo toàn động lượng:
- Tính liên tục: $u_x + v_y = 0$
- Động lượng trục x: $u · u_x + v · u_y + p_x – ν (u_xx + u_yy) = 0$
- Động lượng trục y: $u · v_x + v · v_y + p_y – ν (v_xx + v_yy) = 0$
Trong PyTorch, việc tính đạo hàm bậc hai đòi hỏi cờ create_graph=True để lưu vết đồ thị tính toán đạo hàm cấp một:
def _grad(outputs, inputs):
    return torch.autograd.grad(
        outputs, inputs,
        grad_outputs=torch.ones_like(outputs),
        create_graph=True, retain_graph=True,
        allow_unused=True, materialize_grads=True,
    )[0]

def ns_residuals(model, x, y, nu):
    x, y = x.clone().requires_grad_(True), y.clone().requires_grad_(True)
    u, v, p = model(x, y)

    u_x, u_y = _grad(u, x), _grad(u, y)
    v_x, v_y = _grad(v, x), _grad(v, y)
    p_x, p_y = _grad(p, x), _grad(p, y)

    u_xx, u_yy = _grad(u_x, x), _grad(u_y, y)
    v_xx, v_yy = _grad(v_x, x), _grad(v_y, y)

    continuity = u_x + v_y
    momentum_u = u * u_x + v * u_y + p_x - nu * (u_xx + u_yy)
    momentum_v = u * v_x + v * v_y + p_y - nu * (v_xx + v_yy)
    return continuity, momentum_u, momentum_v
Hàm mất mát tổng thể cân bằng giữa 3 thành phần:
- Mất mát dữ liệu cảm biến: Trọng số 100, đo sai số bình phương trên 40 điểm đo.
- Mất mát phương trình vi phân (PDE): Trọng số 10, tính toán trên 2.500 điểm chuẩn nội suy (collocation points) rải khắp trường dòng chảy. Cứ sau 200 epoch, các điểm này được lấy mẫu lại, trong đó 30% điểm tập trung vào khu vực có số dư PDE lớn nhất.
- Mất mát điều kiện biên: Trọng số 10, ép điều kiện không trượt (no-slip) trên thành mạch, biên dòng vào dạng parabol và áp suất tự do tại lối ra.
Mô hình được huấn luyện bằng thuật toán Adam trong 10.000 epoch kèm kỹ thuật suy giảm tốc độ học (learning rate decay), sau đó tinh chỉnh tiếp 400 bước bằng thuật toán tối ưu bậc hai L-BFGS (tổng thời gian khoảng 35 phút trên 3 luồng CPU).
Biến độ nhớt thành tham số có thể học
Trong bài toán ngược, độ nhớt $
u$ là ẩn số chưa biết. Thay vì gán cứng hằng số, $
u$ được khởi tạo dưới dạng một tham số nơ-ron học đồng thời: log_nu = torch.nn.Parameter(...). Việc lưu giá trị logarit giúp đảm bảo độ nhớt luôn dương và đưa bước nhảy Adam về biên độ hợp lý đối với giá trị nhỏ ($
u = 0.005$).
log_nu = torch.nn.Parameter(torch.tensor(float(np.log(nu_start))))
optimizer = torch.optim.Adam([
    {"params": model.parameters(), "lr": 1e-3},
    {"params": [log_nu], "lr": 1e-3},
])

# Trong hàm tính mất mát:
nu = torch.exp(log_nu)
Để chứng minh kết quả suy luận đến từ dữ liệu cảm biến chứ không phụ thuộc vào giá trị khởi tạo, tác giả cho chạy hai thử nghiệm với điểm xuất phát cực đoan: một phiên bắt đầu gấp 4 lần giá trị thực, phiên khác chỉ bằng 1/3 giá trị thực.
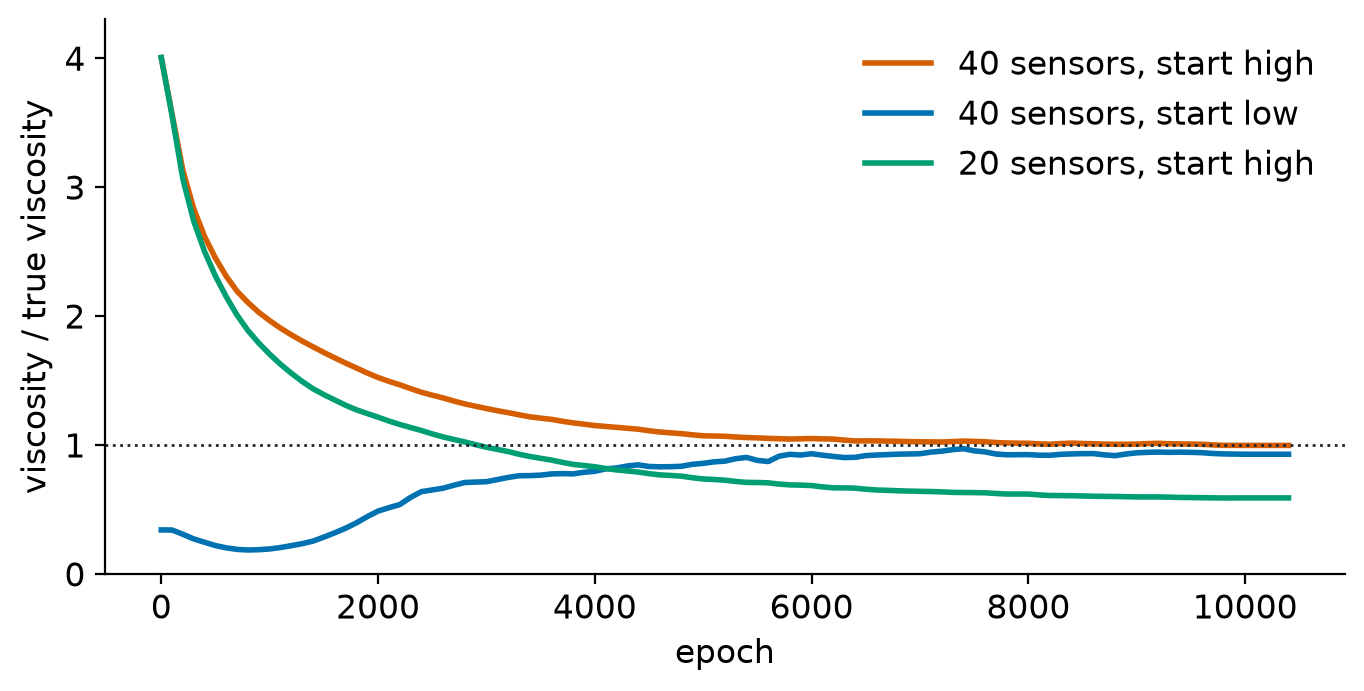
Hiện tượng phân kỳ khi chỉ dùng 20 cảm biến cho thấy: nếu dữ liệu quá thưa, mạng nơ-ron không đủ thông tin để phân biệt giữa trường hợp “chất lỏng đặc hơn, dòng chảy êm hơn” với “chất lỏng loãng hơn, dòng chảy gắt hơn”, dẫn đến việc tham số độ nhớt bị sai lệch từ 25% đến 50% dù đường cong hàm mất mát vẫn giảm đều.
Kết quả tái tạo trường dòng chảy và ứng suất cắt
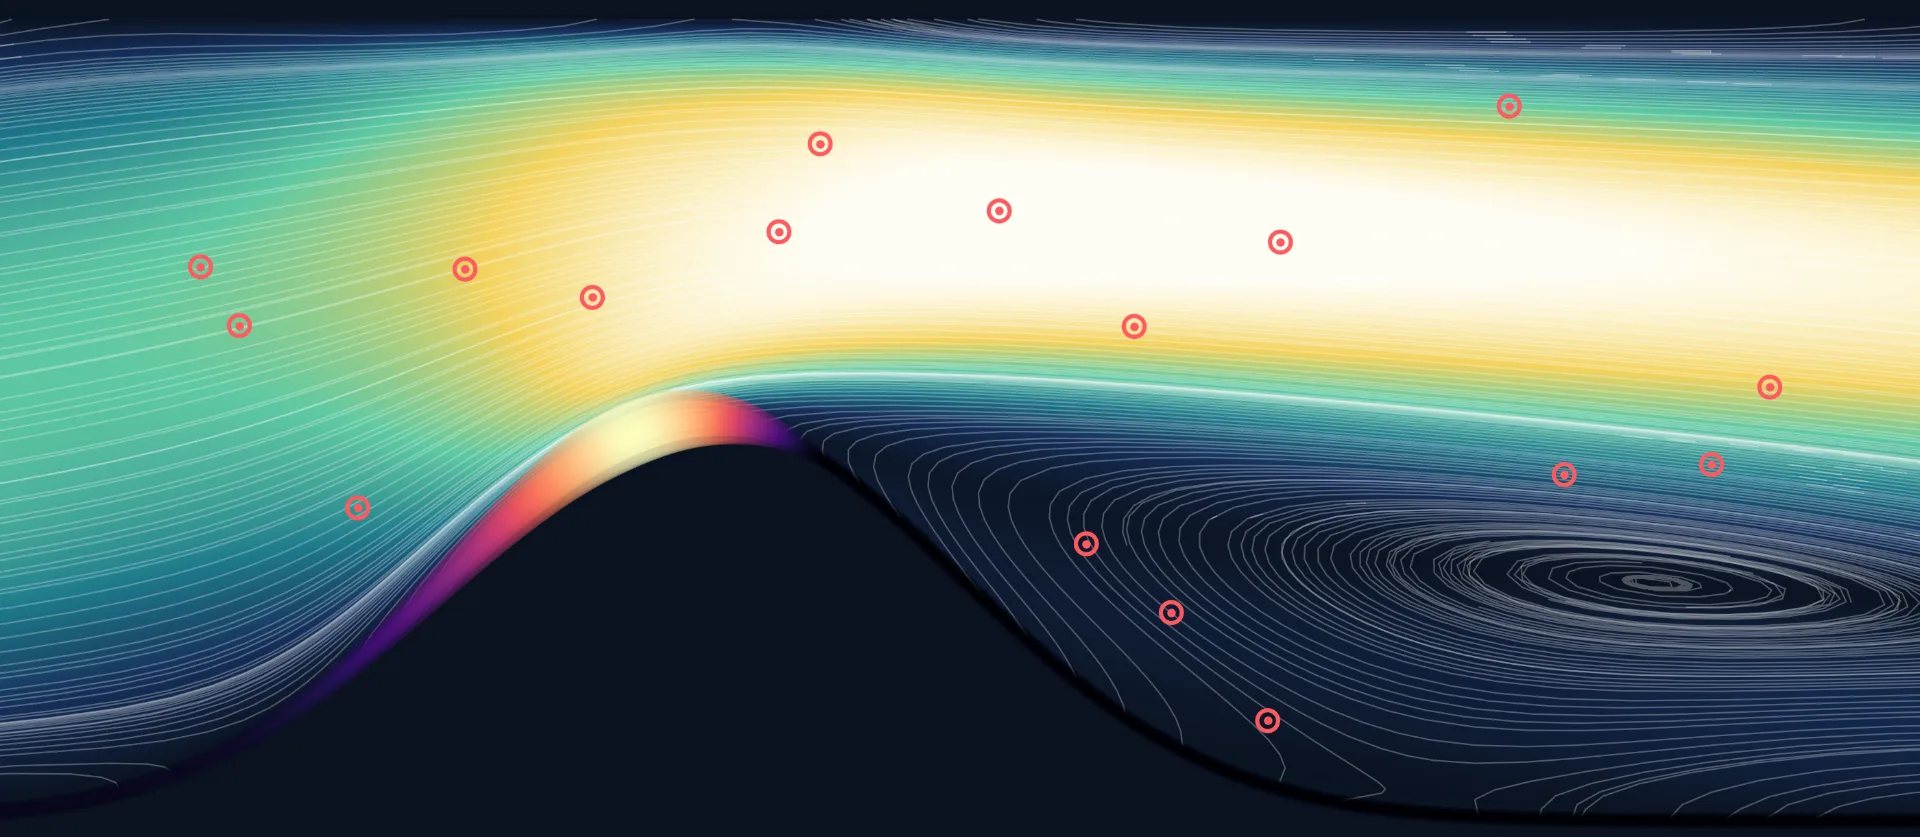
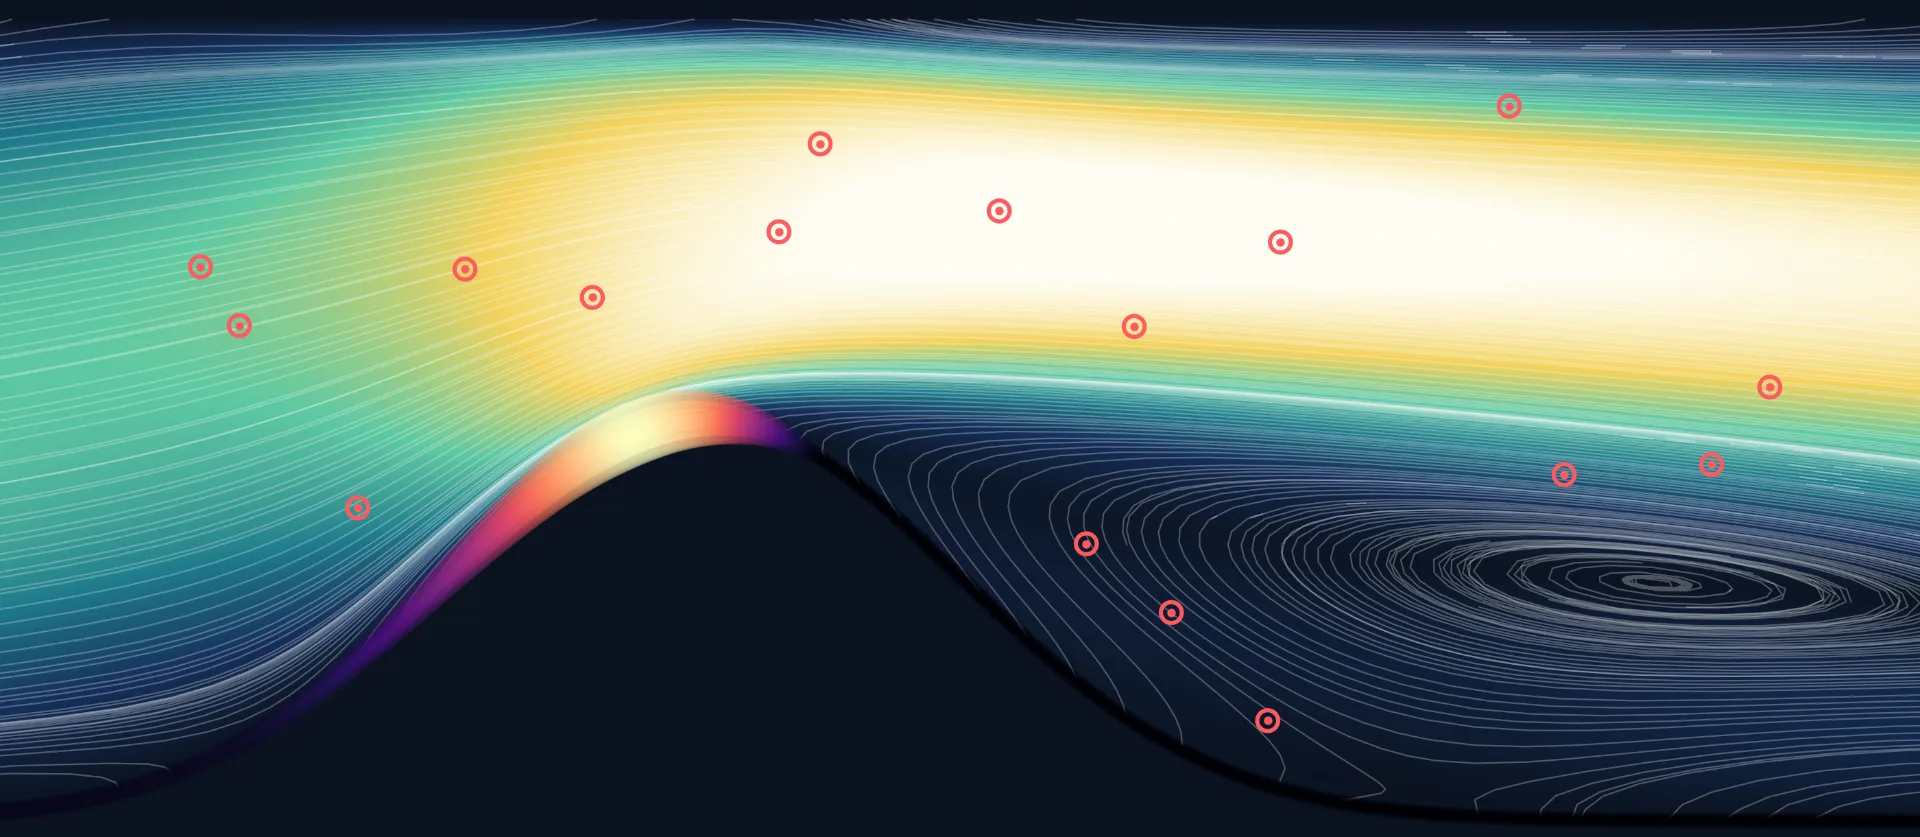
So sánh với mô phỏng thủy động lực học tính toán đối chứng (CFD reference), trường vận tốc do mạng PINN khôi phục chỉ sai lệch vài phần trăm — tương đương với biên độ nhiễu gán vào cảm biến ban đầu.
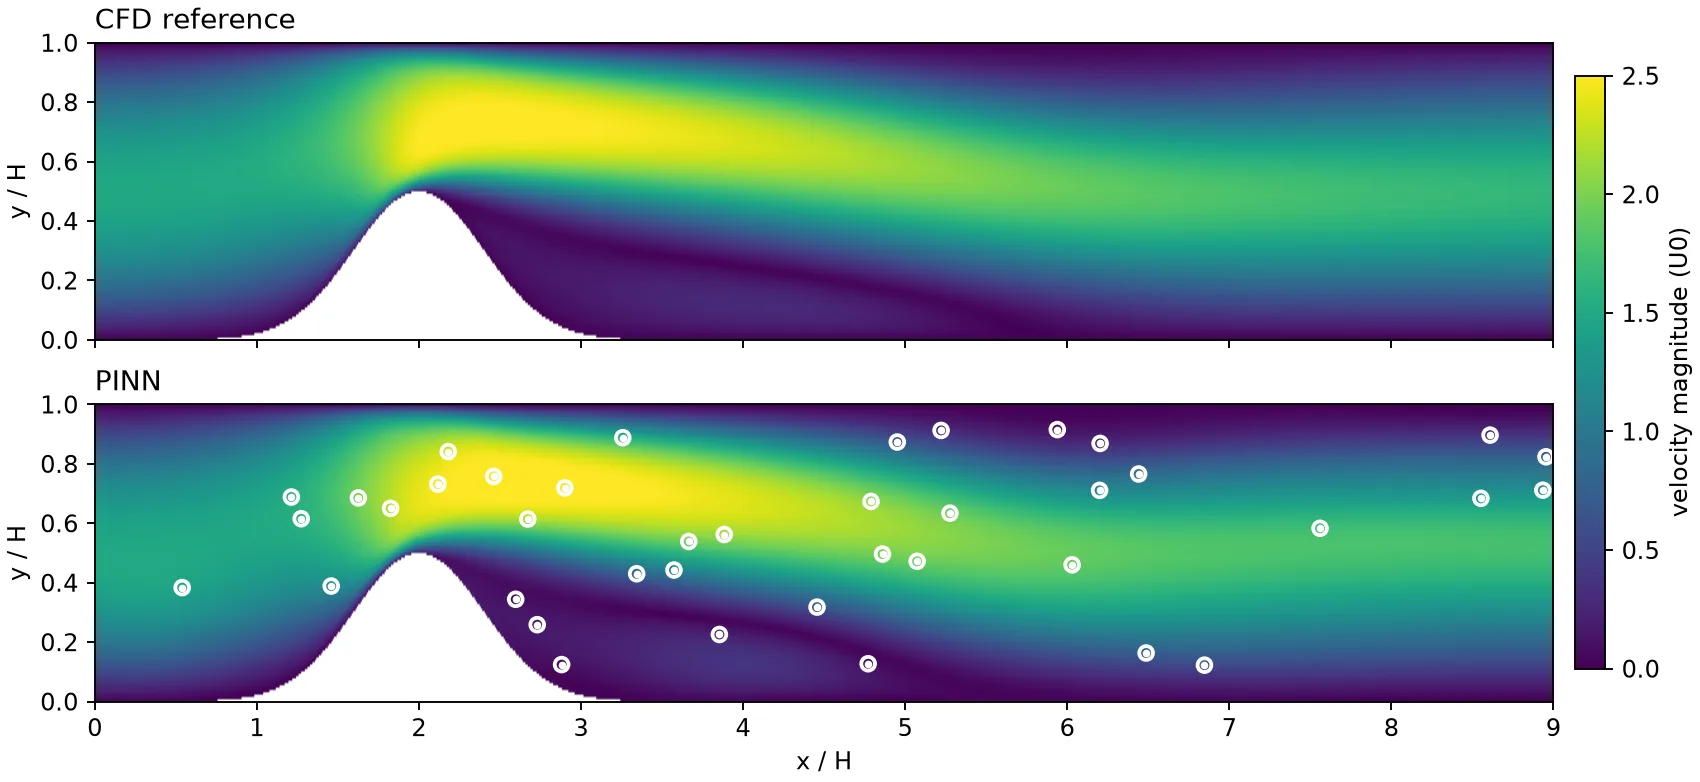
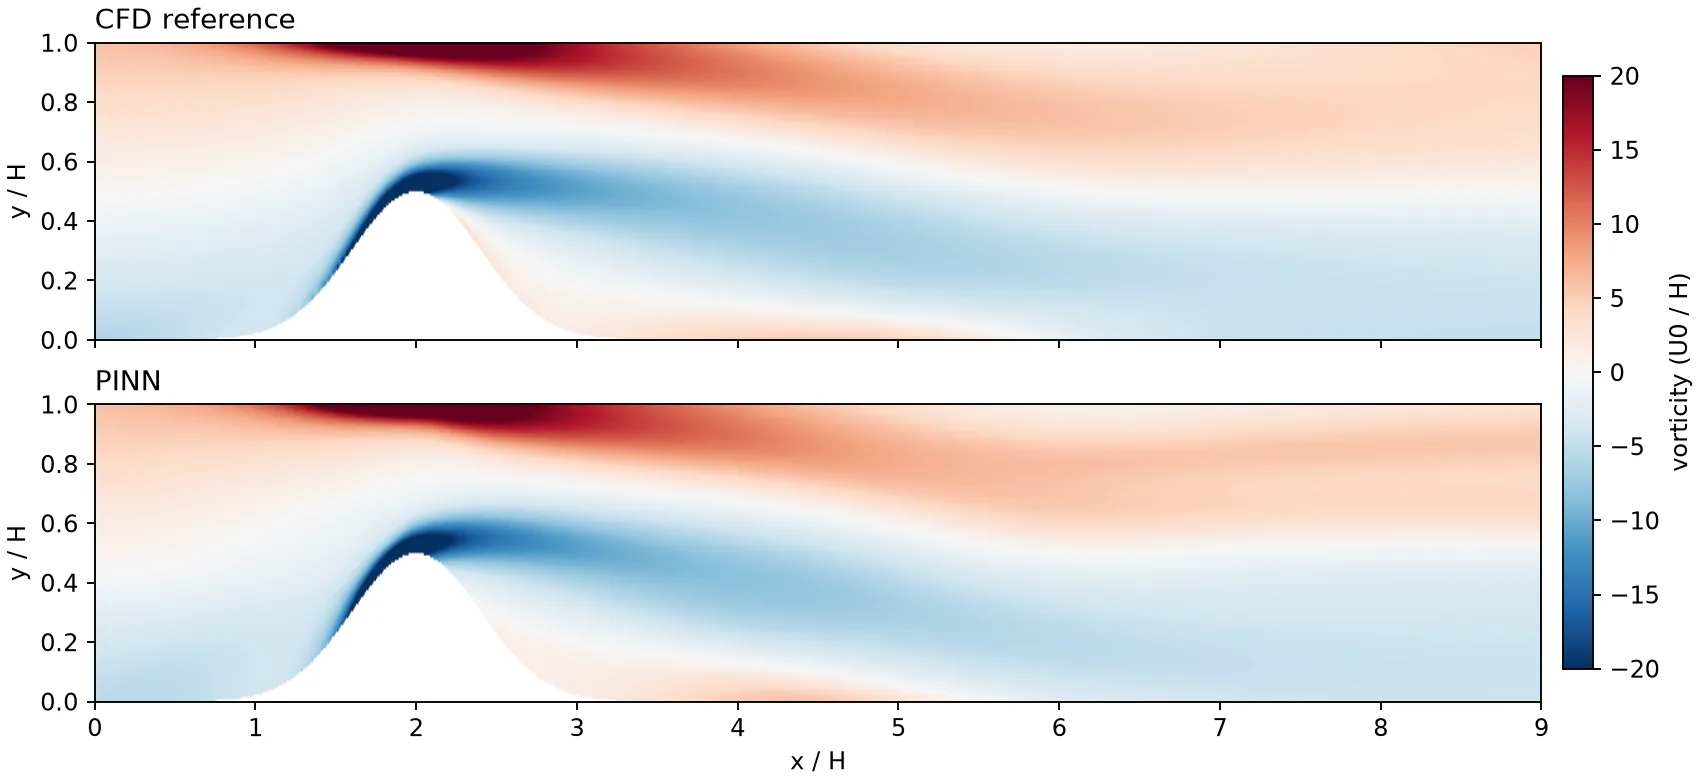
Đặc biệt, mạng PINN tái tạo chuẩn xác trường độ xoáy (vorticity) và nắm bắt hoàn hảo vùng dòng chảy ngược (recirculation bubble) phía sau chỗ hẹp: trên mô hình CFD vùng này bắt đầu từ $x = 2.2$ và đóng lại tại $x = 5.75$, trong khi mạng PINN xác định điểm bắt đầu tại $x = 2.2$ và đóng lại tại $x = 5.6$. Lưu ý rằng hoàn toàn không có cảm biến nào được đặt sát thành ống; kết quả này hoàn toàn do sự phối hợp giữa phương trình Navier-Stokes và dữ liệu vận tốc điểm tạo nên.
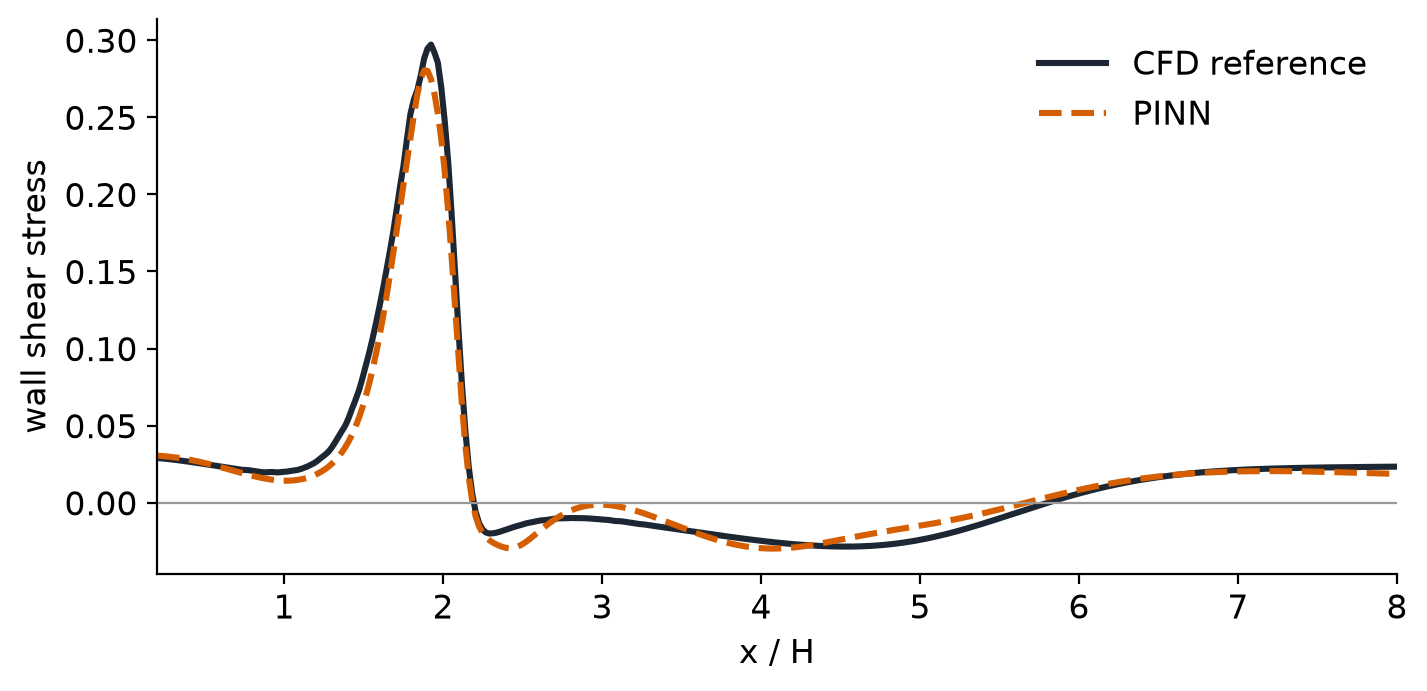
Giá trị độ nhớt ước lượng đạt 0.00498 (so với giá trị thực 0.005), đạt sai số dưới 1%. Đường cong ứng suất cắt thành mạch (wall shear stress) bám rất sát mô phỏng đối chứng: bắt đúng vị trí đỉnh tại cổ hẹp, nhận diện điểm đổi dấu vận tốc và khoảng giá trị âm nông trong vùng dòng chảy đảo chiều.
Những yếu tố quyết định thành bại
Bảng tổng hợp dưới đây phân tích tác động của các thay đổi cấu hình đối với hiệu năng mô hình:
| Biến thể cấu hình thử nghiệm | Tác động thực tế đến kết quả |
|---|---|
| Giảm xuống 20 cảm biến (thay vì 40) | Độ nhớt sai lệch nghiêm trọng từ 25% đến 50%; sai số vận tốc tăng cao. |
| Tăng lên 60 cảm biến | Kết quả gần như tương đương với mốc 40 cảm biến, không tăng thêm độ chính xác. |
| 40 cảm biến rải đều (không chia dải) | Trường độ xoáy mờ hơn một chút; sai số độ nhớt nằm trong khoảng 8%. |
| Bỏ điều kiện biên dòng ra | Kết quả gần như không đổi nếu đoạn kênh đủ dài. |
| Mở rộng mạng (4 lớp x 96 nơ-ron) | Không cải thiện độ chính xác, tốc độ huấn luyện chậm hơn gấp đôi. |
| Trọng số PDE đặt bằng 1 (thay vì 10) | Sai số vận tốc tăng hơn gấp 2 lần do ràng buộc vật lý quá yếu. |
Thực nghiệm chứng minh rằng mật độ dữ liệu đo đạc (đạt ngưỡng 40 cảm biến) là yếu tố mang tính quyết định số một để ghim chặt giá trị độ nhớt về nghiệm đúng, vượt xa ảnh hưởng của việc tinh chỉnh siêu tham số tối ưu hay cấu trúc mạng nơ-ron.
Nguồn: Towards Data Science

LIÊN HỆ TƯ VẤN CÁC DỊCH VỤ AI
Hỗ trợ tư vấn, đào tạo và chuyển giao AI cho cá nhân, doanh nghiệp và tổ chức.
 Liên hệ qua Zalo