LIÊN HỆ HOTLINE/ZALO: 0981.243.678
Đo lường tiềm năng sáng tạo của tác tử LLM trên bài toán kỹ thuật máy học
Khung đánh giá mới đo lường tính sáng tạo của tác tử LLM qua độ mới tâm lý, độ mới lịch sử và hiệu năng thực tế trên các cuộc thi kỹ thuật máy học.
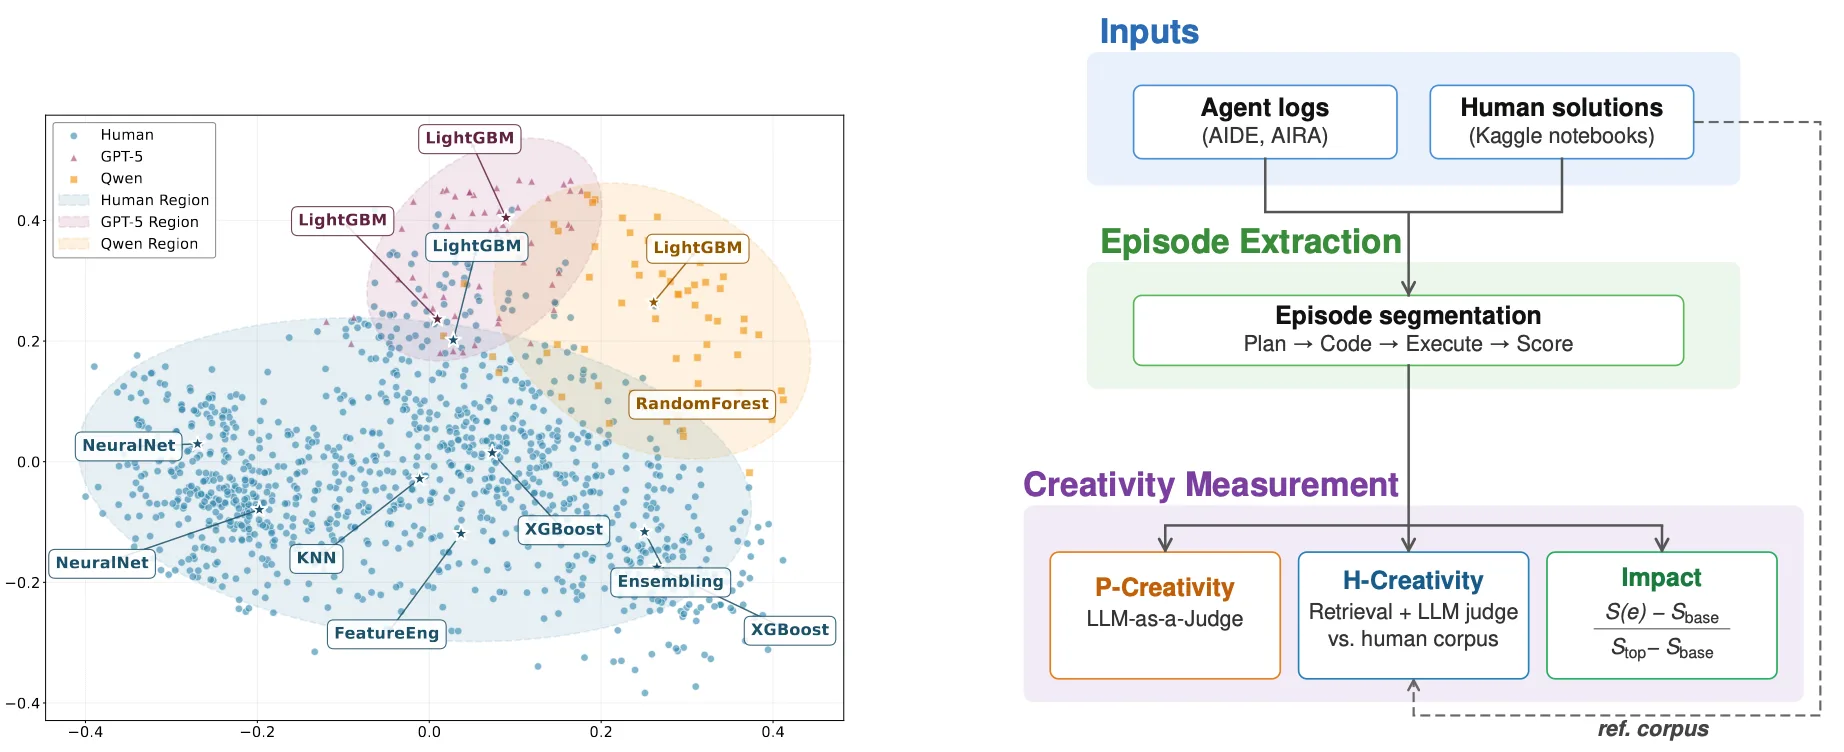
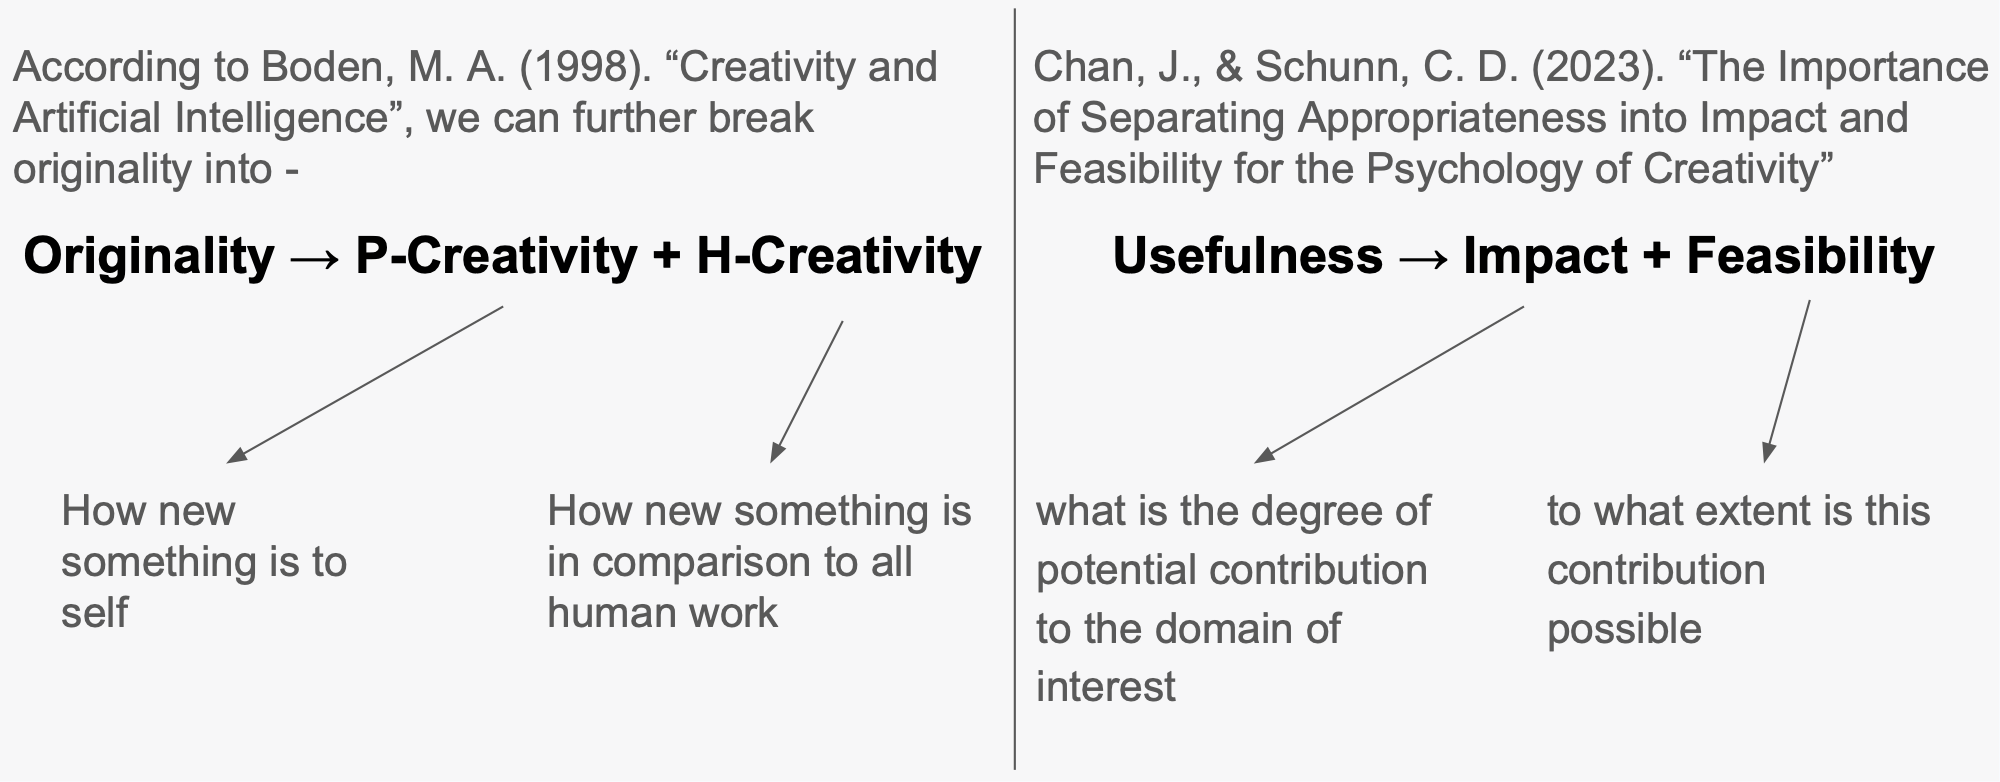
Nghiên cứu mới công bố từ Đại học Michigan trên bộ tiêu chuẩn kiểm chuẩn MLE-bench (tổng hợp từ 75 cuộc thi Machine Learning thực tế của Kaggle) đã trực tiếp giải đáp câu hỏi nền tảng: liệu các tác tử mô hình ngôn ngữ lớn (LLM agents) có thực sự sở hữu năng lực khám phá ra giải pháp mới, hay chúng chỉ đang tổ hợp lại các ý tưởng sẵn có trong không gian kinh nghiệm của con người?
Để đánh giá năng lực này một cách định lượng thay vì dựa vào các nhận định cảm tính, nhóm nghiên cứu đã xây dựng một khung đánh giá toàn diện dựa trên lý thuyết tâm lý học sáng tạo của Margaret Boden, tách bạch rõ ràng giữa tính độc bản và giá trị ứng dụng thực tế.
Bản chất cấu thành của tính sáng tạo trong kỹ thuật máy học
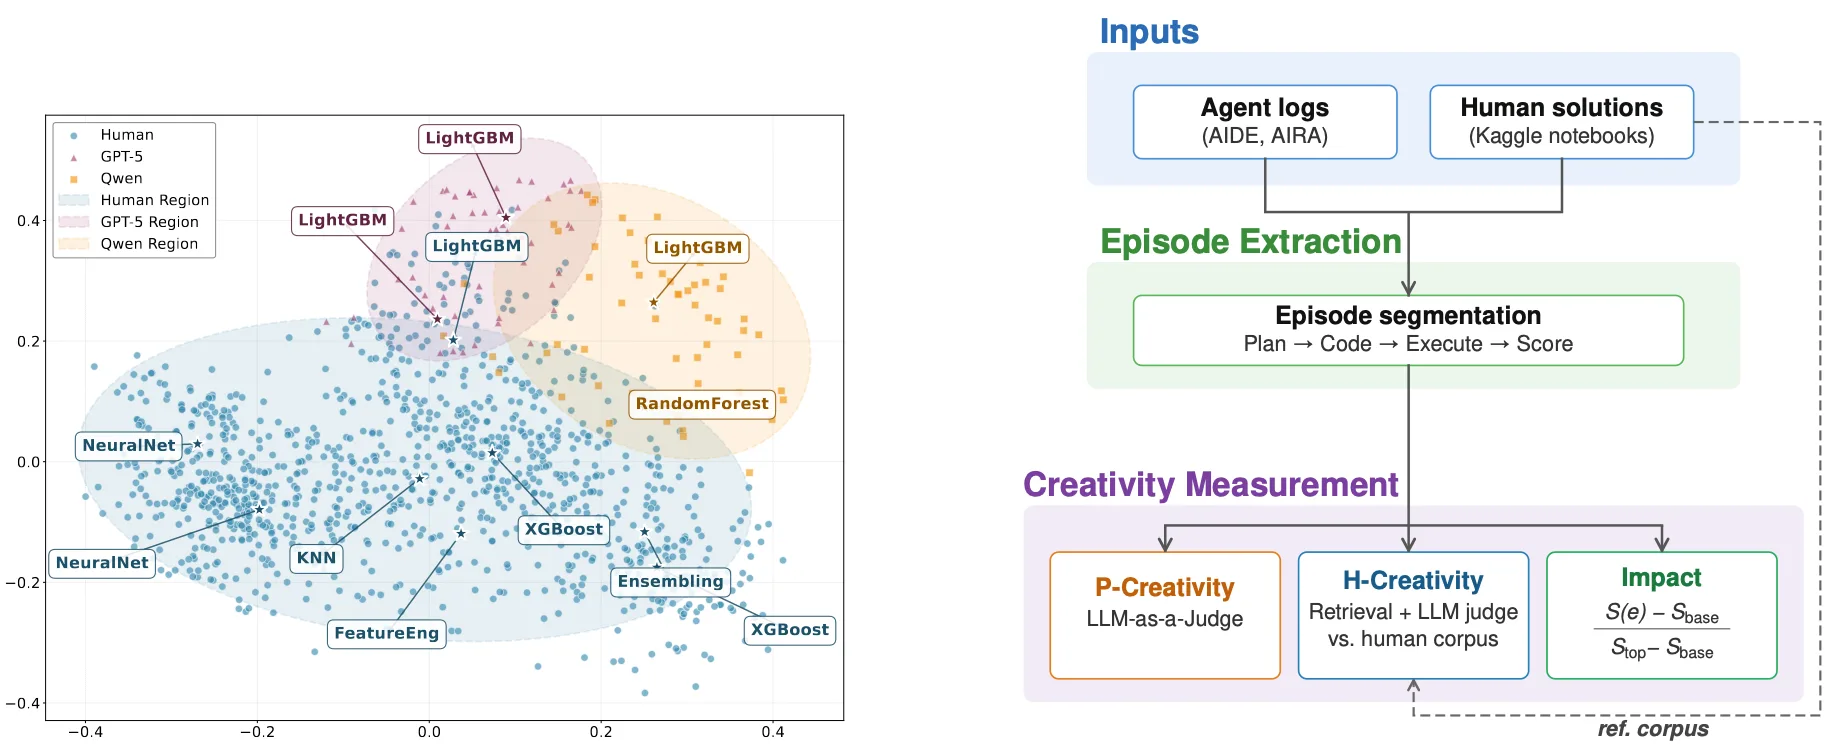
Theo định nghĩa kinh điển của nhà nghiên cứu nhận thức Margaret Boden, tính sáng tạo (creativity) là giao thoa giữa hai yếu tố không thể tách rời: tính độc bản (originality) và tính hữu dụng (usefulness).
Nhóm tác giả đã chuẩn hóa và phân rã hai yếu tố này thành 4 chỉ số kỹ thuật có thể đo lường định lượng trên mã nguồn:
- Tính sáng tạo cá nhân (P-creativity / Psychological novelty): Đo lường mức độ mới mẻ của một giải pháp so với chính lịch sử hoạt động và bộ nhớ nội tại của tác tử. Chỉ số này phản ánh năng lực tự đào sâu và không lặp lại chính mình.
- Tính sáng tạo lịch sử (H-creativity / Historical novelty): Đo lường mức độ mới mẻ của giải pháp so với toàn bộ kho tàng tri thức nhân loại (ở đây là toàn bộ các lời giải và mã nguồn do cộng đồng chuyên gia con người từng nộp trong cuộc thi).
- Mức độ tác động (impact): Mức độ cải thiện thực tế trên thước đo hiệu năng mục tiêu của bài toán (ví dụ: điểm F1-score, độ chính xác hoặc AUC).
- Tính khả thi (feasibility): Đo lường việc mã nguồn do tác tử sinh ra có thể biên dịch, chạy trơn tru không lỗi và hội tụ trong phạm vi tài nguyên cho phép hay không.
Thiết lập thử nghiệm trên bài toán phân loại bệnh lá sắn
Thử nghiệm được triển khai trên hai kiến trúc tác tử tiêu biểu: AIDE (tác tử tìm kiếm dạng cây theo chiến lược tham lam – greedy tree-search) và AIRA-Dojo (mở rộng từ AIDE với việc bổ sung đa dạng chiến lược tìm kiếm và toán tử tối ưu). Các mô hình nền tảng được kiểm thử là GPT-5 và Qwen3-32B. Mỗi bài toán được thiết lập 8 phiên chạy độc lập, giới hạn ngân sách thời gian 8 giờ và tối đa 10 phiên giải (episodes).
Điểm giá trị của tập kiểm chuẩn MLE-bench là sự hiện diện của quỹ đạo giải pháp người (human trajectories) được lưu vết trọn vẹn trong 3 tháng diễn ra cuộc thi. Điều này cho phép đối chiếu trực tiếp từng bước chuyển tư duy của AI với các kỹ sư dữ liệu con người.
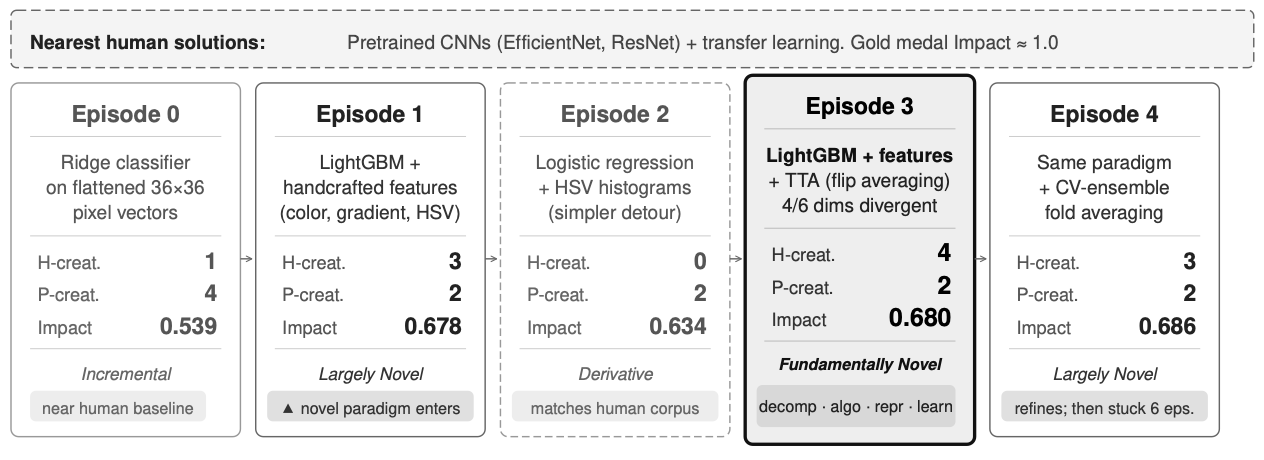
Phương pháp đo lường P-creativity và H-creativity trên quy mô lớn
Để đánh giá hàng nghìn phiên mã nguồn mà không thể dùng chuyên gia chấm thủ công, nghiên cứu đã cho 3 chuyên gia gán nhãn 300 phiên giải làm tập đối chứng, sau đó so sánh các phương pháp tự động: khoảng cách ngữ nghĩa (semantic distance), độ bất ngờ (surprisal), tính mới mẻ khái niệm (conceptual novelty) và LLM-as-a-Judge.
Kết quả chỉ ra rằng mô hình LLM-as-a-Judge sử dụng GPT-5 đạt hệ số tương quan thứ hạng Spearman cao nhất với đánh giá của con người (vượt xa các phương pháp tiếp cận dựa trên vector nhúng embedding thuần túy).
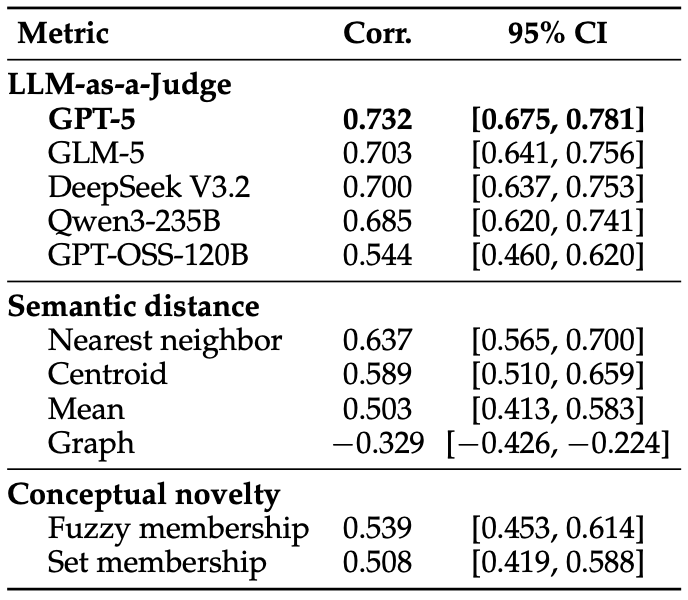
Đối với chỉ số H-creativity, do kho mã nguồn của con người vượt quá độ dài ngữ cảnh của LLM, nhóm áp dụng quy trình 2 bước: sử dụng khoảng cách ngữ nghĩa để lọc ra 5 giải pháp của con người tương đồng nhất, sau đó dùng LLM-as-a-Judge chấm điểm so sánh trên thang từ 0 đến 4.
Quy luật chuyển dịch từ khám phá sang khai thác
Dữ liệu thực nghiệm cho thấy một quy luật phổ quát ở tất cả các tác tử: xu hướng dịch chuyển nhanh chóng từ khám phá (exploration) sang khai thác (exploitation). Khi được cấp thêm tài nguyên tính toán lúc suy luận (test-time compute), tác tử chỉ dành vài bước đầu để thử nghiệm ý tưởng mới, sau đó nhanh chóng tập trung tinh chỉnh hẹp trên một phương pháp cố định.
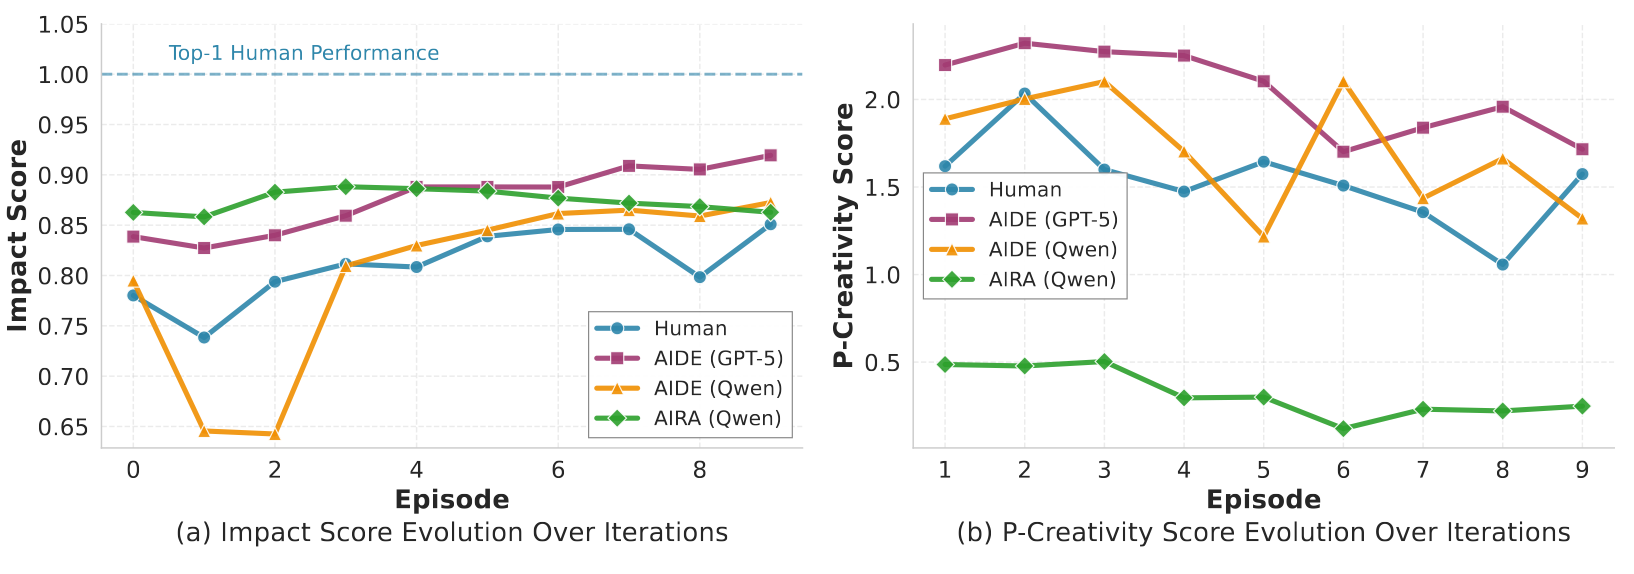
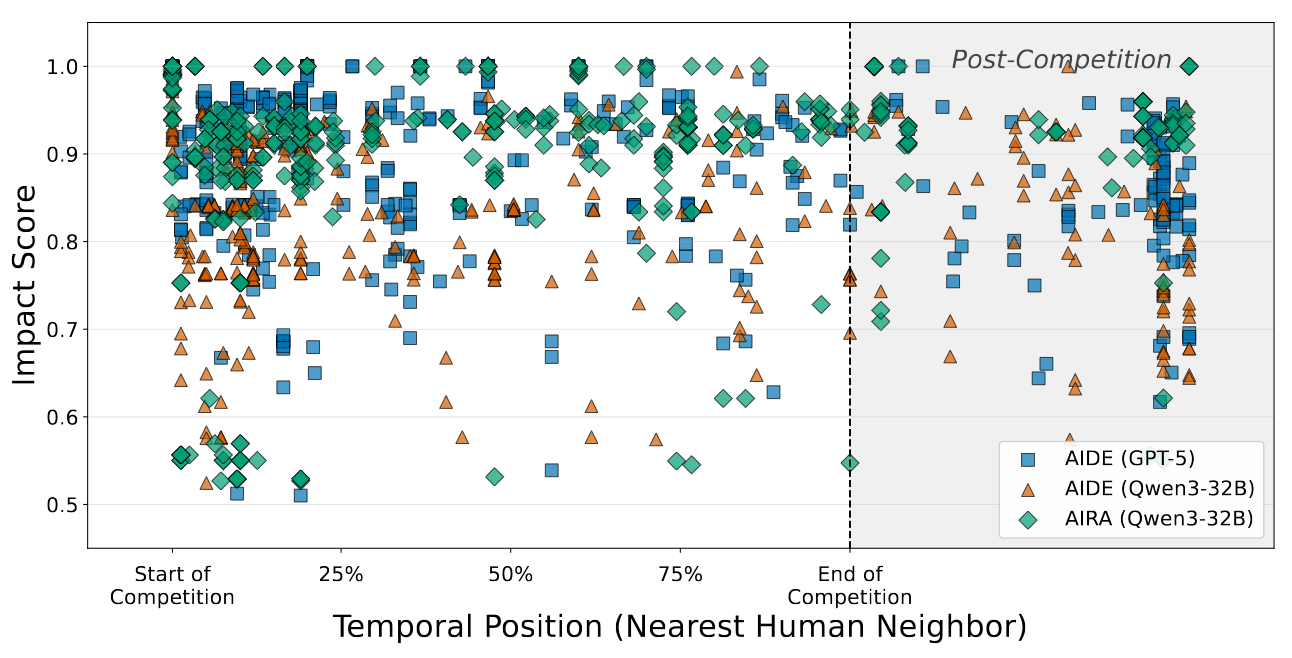
Phân tích chuỗi suy luận (reasoning traces) xác nhận: các truy vết mang tính khám phá chiến lược chiếm tới 75% ở đầu phiên chạy, nhưng tụt dốc xuống chỉ còn 25% ở giai đoạn cuối. Đáng lưu ý, P-creativity và tác động (impact) hầu như không tương quan với nhau — việc theo đuổi một ý tưởng độc lạ hoàn toàn không bảo đảm điểm số sẽ gia tăng.
Ảnh hưởng của chiến lược tìm kiếm
Thử nghiệm so sánh 3 chiến lược tìm kiếm trong AIRA-Dojo (Qwen3-32B) gồm tìm kiếm tham lam (Greedy search), tìm kiếm cây Monte Carlo (MCTS) và thuật toán tiến hóa (Evolutionary search) đem lại phát hiện bất ngờ: các chiến lược khác nhau không tạo ra quỹ đạo quá khác biệt về mặt đường dài.
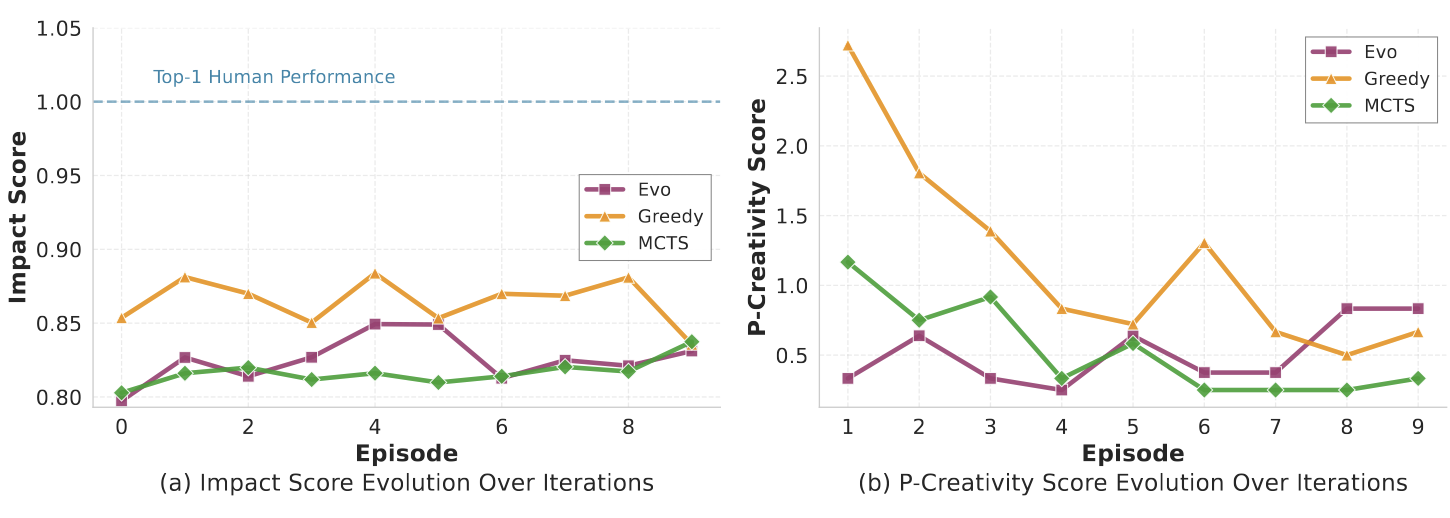
Kết quả này khẳng định rằng thuật toán tìm kiếm đơn lẻ không thể thay thế cho khung điều phối (scaffolding), cách thức định dạng prompt và cơ chế truyền ngữ cảnh. Một tác tử muốn sáng tạo bền vững cần sự đồng bộ của toàn bộ hạ tầng công cụ phụ trợ xung quanh.
Nghịch lý sáng tạo: Tác tử chạm tới vùng mới mẻ nhưng thiếu năng lực chuyển hóa
Khi đo lường chỉ số H-creativity của các tác tử so với các chuyên gia con người đạt huy chương sau giải đấu, một nghịch lý lớn đã lộ diện:
| Nhóm đối tượng thử nghiệm | Điểm số H-Creativity (thang 0 đến 4) |
|---|---|
| AIDE (GPT-5) | 1.423 |
| AIDE (Qwen3-32B) | 0.838 |
| AIRA-MCTS (Qwen3-32B) | 0.800 |
| Con người đạt Huy chương Vàng (Gold Medalist) | 0.744 |
| Con người đạt Huy chương Bạc (Silver Medalist) | 0.524 |
| Con người đạt Huy chương Đồng (Bronze Medalist) | 0.293 |
Tác tử GPT-5 với AIDE đạt độ mới mẻ lịch sử lên tới 1.423 — cao gần gấp đôi con người đạt Huy chương Vàng (0.744). Tuy nhiên, chỉ có vỏn vẹn 21% số lượt chạy của GPT-5 giành được huy chương thực tế. Điều này chứng minh: tác tử AI rất giỏi đề xuất các ý tưởng dị biệt và mới lạ, nhưng phần lớn các ý tưởng này thất bại trong việc chuyển hóa thành giá trị thực tiễn vì thiếu tính khả thi kỹ thuật hoặc sai sót logic ngầm.
Định hướng cho nghiên cứu khoa học tự hành
Phát hiện trên đặt ra một yêu cầu bắt buộc cho kỹ thuật phát triển tác tử tương lai: cần thiết lập cơ chế tối ưu hóa kép (dual optimization), vừa định hướng mô hình tìm kiếm tính độc bản vừa kiểm soát chặt chẽ tính khả thi và tác động thực nghiệm qua học tăng cường (RL).
Trong giai đoạn hiện tại, mô hình hợp tác bổ trợ giữa con người và AI (Human-AI complementarity) vẫn là con đường tối ưu nhất: con người định hình không gian bài toán và đánh giá tính khả thi, trong khi tác tử AI đảm nhận việc rà quét và thử nghiệm các hướng giải pháp đột phá trên diện rộng.
Nguồn: Towards Data Science

LIÊN HỆ TƯ VẤN CÁC DỊCH VỤ AI
Hỗ trợ tư vấn, đào tạo và chuyển giao AI cho cá nhân, doanh nghiệp và tổ chức.
 Liên hệ qua Zalo